


専用設計の産業用GPUコンピュータを使用して、最先端のAIテクノロジーをオンプレミス環境に導入しましょう。Premioのx86およびARMシステムは、NVIDIA GPUとJetsonモジュールアクセラレータを搭載し、ミッションクリティカルなマシンビジョンアプリケーションにリアルタイムのAI推論を提供します。
- さまざまなエッジAIワークロードに対応したカスタマイズソリューション
- NVIDIAプロフェッショナルGPUまたはJetson Orinシステムオンモジュール(SoM)をサポートします。
- UL認証取得済み(安全性および信頼性)
- 超堅牢型および半堅牢型コンピューティングソリューション
エッジAIワークロード向け産業用GPUコンピュータ
Premioの産業用GPUコンピュータ製品群は、幅広いエッジAIワークロードに対応できるよう専用設計されています。低消費電力の推論から高スループットのトレーニング、マルチモーダル処理まで、当社のソリューションは、過酷なエッジ環境、管理された産業環境、コンパクトなオンプレミスデータセンターなど、あらゆる環境に対応します。


NVIDIA RTX PRO 6000
アーキテクチャ:Blackwell | GPUメモリ:96GB GDDR7 ECC | TDP:600W
RTX PRO 6000 Blackwell Workstation Editionは、NVIDIAの最新Blackwellアーキテクチャをベースにした96GB GDDR7搭載の高性能GPUで、デスクトップワークステーションから高度なAI、3D、ビジュアライゼーションのワークロードを処理できるように設計されています。
詳細はこちら...


NVIDIA RTX PRO 6000
アーキテクチャ:Blackwell | GPUメモリ:96GB GDDR7 ECC | TDP:300W
RTX PRO 6000 Blackwell Workstation Editionは、NVIDIAの最新Blackwellアーキテクチャをベースにした96GB GDDR7搭載の高性能GPUで、デスクトップワークステーションから高度なAI、3D、ビジュアライゼーションのワークロードを処理できるように設計されています。
詳細はこちら...


NVIDIA RTX PRO 5000
アーキテクチャ:Blackwell | GPUメモリ:72GB GDDR7 ECC | TDP:300W
RTX PRO 5000は、ローカルLLM実行、高度なビジョン分析、大規模な生成AIを必要とするエッジ環境向けに、最高のAI推論パフォーマンスを提供します。過酷な環境におけるオンプレミスAIサーバーに最適です。
詳細はこちら...


NVIDIA RTX PRO 5000
アーキテクチャ:Blackwell | GPUメモリ:48GB GDDR7 ECC | TDP:200W
RTX PRO 5000は、ローカルLLM実行、高度なビジョン分析、大規模な生成AIを必要とするエッジ環境向けに、最高のAI推論パフォーマンスを提供します。過酷な環境におけるオンプレミスAIサーバーに最適です。
詳細はこちら...


NVIDIA RTX PRO 4500
アーキテクチャ:Blackwell | GPUメモリ:32GB GDDR7 ECC | TDP:200W
ジェネレーティブデザイン、ロボット工学、産業オートメーションにおける要求の厳しいワークロード向けに設計されたRTX PRO 4500は、高いAIスループットとエネルギー効率のバランスを取り、複雑なエッジ推論ワークフローをサポートします。
詳細はこちら...


NVIDIA RTX PRO 4000
アーキテクチャ:Blackwell | GPUメモリ:24GB GDDR7 ECC | TDP:140W
このシングルスロットのRTX PRO 4000は、コンパクトな産業用システムで優れたAIパフォーマンスを発揮し、スペースに制約のあるエッジ環境におけるマルチモーダル推論、デジタルツインレンダリング、高度なマシンビジョンに最適です。
詳細はこちら...


NVIDIA RTX PRO 4000 SFF
アーキテクチャ:Blackwell | GPUメモリ:24GB GDDR7 ECC | TDP:70W
小型フォームファクタシステム向けに最適化されたRTX PRO 4000 SFFは、低消費電力でコンパクトなGPUに本格的なAIパフォーマンスを詰め込んでいます。スペースが限られた環境でのビジョンベースの推論やリアルタイムのエッジ分析に最適です。
詳細はこちら...


NVIDIA RTX PRO 2000
アーキテクチャ:Blackwell | GPUメモリ:16GB GDDR7 ECC | TDP:70W
エネルギー効率の高いエッジAIコンピューティング向けに設計されたRTX 2000 PROは、コンパクトなサイズを維持しながら、優れた推論機能を提供します。スマートマニュファクチャリングや産業用ロボットなど、幅広い用途に対応します。
詳細はこちら...


NVIDIA RTX 5000 ADA
アーキテクチャ:Ada Lovelace | GPUメモリ:32GB GDDR6 ECC | TDP:250W
RTX 5000 Adaは、ローカルLLM実行、高度なビジョン分析、大規模な生成AIを必要とするエッジ環境向けに、最高のAI推論パフォーマンスを提供します。過酷な環境におけるオンプレミスAIサーバーに最適です。詳細はこちら...
NVIDIA RTX 4500 ADA
アーキテクチャ:Ada Lovelace | GPUメモリ:24GB GDDR6 ECC | TDP:210W
ジェネレーティブデザイン、ロボット工学、産業オートメーションにおける要求の厳しいワークロード向けに設計されたRTX 4500 Adaは、高いAIスループットとエネルギー効率のバランスを取り、複雑なエッジ推論ワークフローをサポートします。
詳細はこちら...
NVIDIA RTX 4000 ADA
アーキテクチャ:Ada Lovelace | GPUメモリ:20GB GDDR6 ECC | TDP:130W
このシングルスロットのRTX 4000 Adaは、コンパクトな産業用システムで優れたAIパフォーマンスを発揮し、スペースに制約のあるエッジ環境におけるマルチモーダル推論、デジタルツインレンダリング、高度なマシンビジョンに最適です。
詳細はこちら...
NVIDIA RTX A4000
アーキテクチャ:Ampere | GPUメモリ:16GB GDDR6 ECC | TDP:140W
主流のエッジ推論およびビジュアルAIタスク向けの信頼できるソリューション。RTX A4000は、プロフェッショナルグレードの産業用エッジコンピュータにおけるディープラーニングおよびレイトレーシングワークロードをサポートするように設計されています。
詳細はこちら...


NVIDIA RTX 4000 ADA SFF
アーキテクチャ:Ada Lovelace | GPUメモリ:20GB GDDR6 ECC | TDP:70W
小型フォームファクタシステム向けに最適化されたRTX 4000 SFFは、低消費電力でコンパクトなGPUに本格的なAIパフォーマンスを詰め込んでいます。スペースが限られた環境でのビジョンベースの推論やリアルタイムのエッジ分析に最適です。
詳細はこちら...
NVIDIA RTX 2000 ADA
アーキテクチャ:Ada Lovelace | GPUメモリ:16GB GDDR6 ECC | TDP:70W
エネルギー効率の高いエッジAIコンピューティング向けに設計されたRTX 2000 Adaは、コンパクトなサイズを維持しながら、確かな推論能力を提供します。スマートマニュファクチャリングや産業用ロボットなど、幅広い用途に対応します。
詳細はこちら...
NVIDIA RTX A2000
アーキテクチャ:Ampere | GPUメモリ:6GBまたは12GB GDDR6 ECC | TDP:70W
過剰な電力消費を伴わずにAIアクセラレーションを必要とするエッジシステム向けに設計された薄型GPU。RTX A2000は、目視検査、予知保全、エッジにおける組み込みAIに最適です。
詳細はこちら...


NVIDIA RTX A1000
アーキテクチャ:Ampere | GPUメモリ:8GB GDDR6 ECC | TDP:50W
エントリーレベルのAIアプリケーション向けに設計されたRTX A1000は、省スペースなフォームファクタでリアルタイムのレイAI推論を実現します。物体検出や追跡などの軽量なエッジAIワークロードに最適です。
詳細はこちら...


Jetson AGX Orinシリーズ
AI性能:最大275 TOPS | メモリオプション:64GB、32GB | TDP:15~60W
Jetson AGX Orinは、リアルタイム推論とマルチタスクが不可欠なエッジ環境において、比類のないAIパフォーマンスを提供します。最大275 TOPSの性能と高度なエネルギー構成機能を備え、過酷な環境下で動作するロボット、自律システム、産業用AIサーバーに最適です。詳細はこちら...


Jetson AGX Thorシリーズ
AI性能:最大2070 FP4 TFLOPS | メモリオプション:128 GB | TDP:40~130W
NVIDIA Jetson Thorは、ヒューマノイドロボット向けに設計された高性能コンピュータです。Blackwellアーキテクチャを搭載し、最大2070 TFLOPSのFP4 AI演算能力を発揮することで、大規模な生成型AIモデルをローカルで実行し、リアルタイムのマルチセンサー融合処理を実現します。詳細はこちら...


ジェットソン・オーリンNXシリーズ
AI性能:最大157 TOPS | メモリオプション:16GB、8GB | TDP:7~25W
Jetson Orin NXは、パフォーマンスとサイズの完璧なバランスを実現しています。小型フォームファクタと効率的な電力プロファイルにより、スマートカメラ、自律型マシン、センサーフュージョンワークロードなどの組み込みエッジアプリケーションに最適な選択肢となります。詳細はこちら...


Jetson Orin Nanoシリーズ
AI性能:最大67 TOPS | メモリオプション:8GB、4GB | TDP:7~40W
Jetson Orin Nanoは、エントリーレベルのAI推論機能を超小型システムにもたらします。そのサイズにもかかわらず、高度なAI機能を搭載しており、ビジョンAI、異常検知、エッジにおける低消費電力の産業用途に最適です。
詳細はこちら...

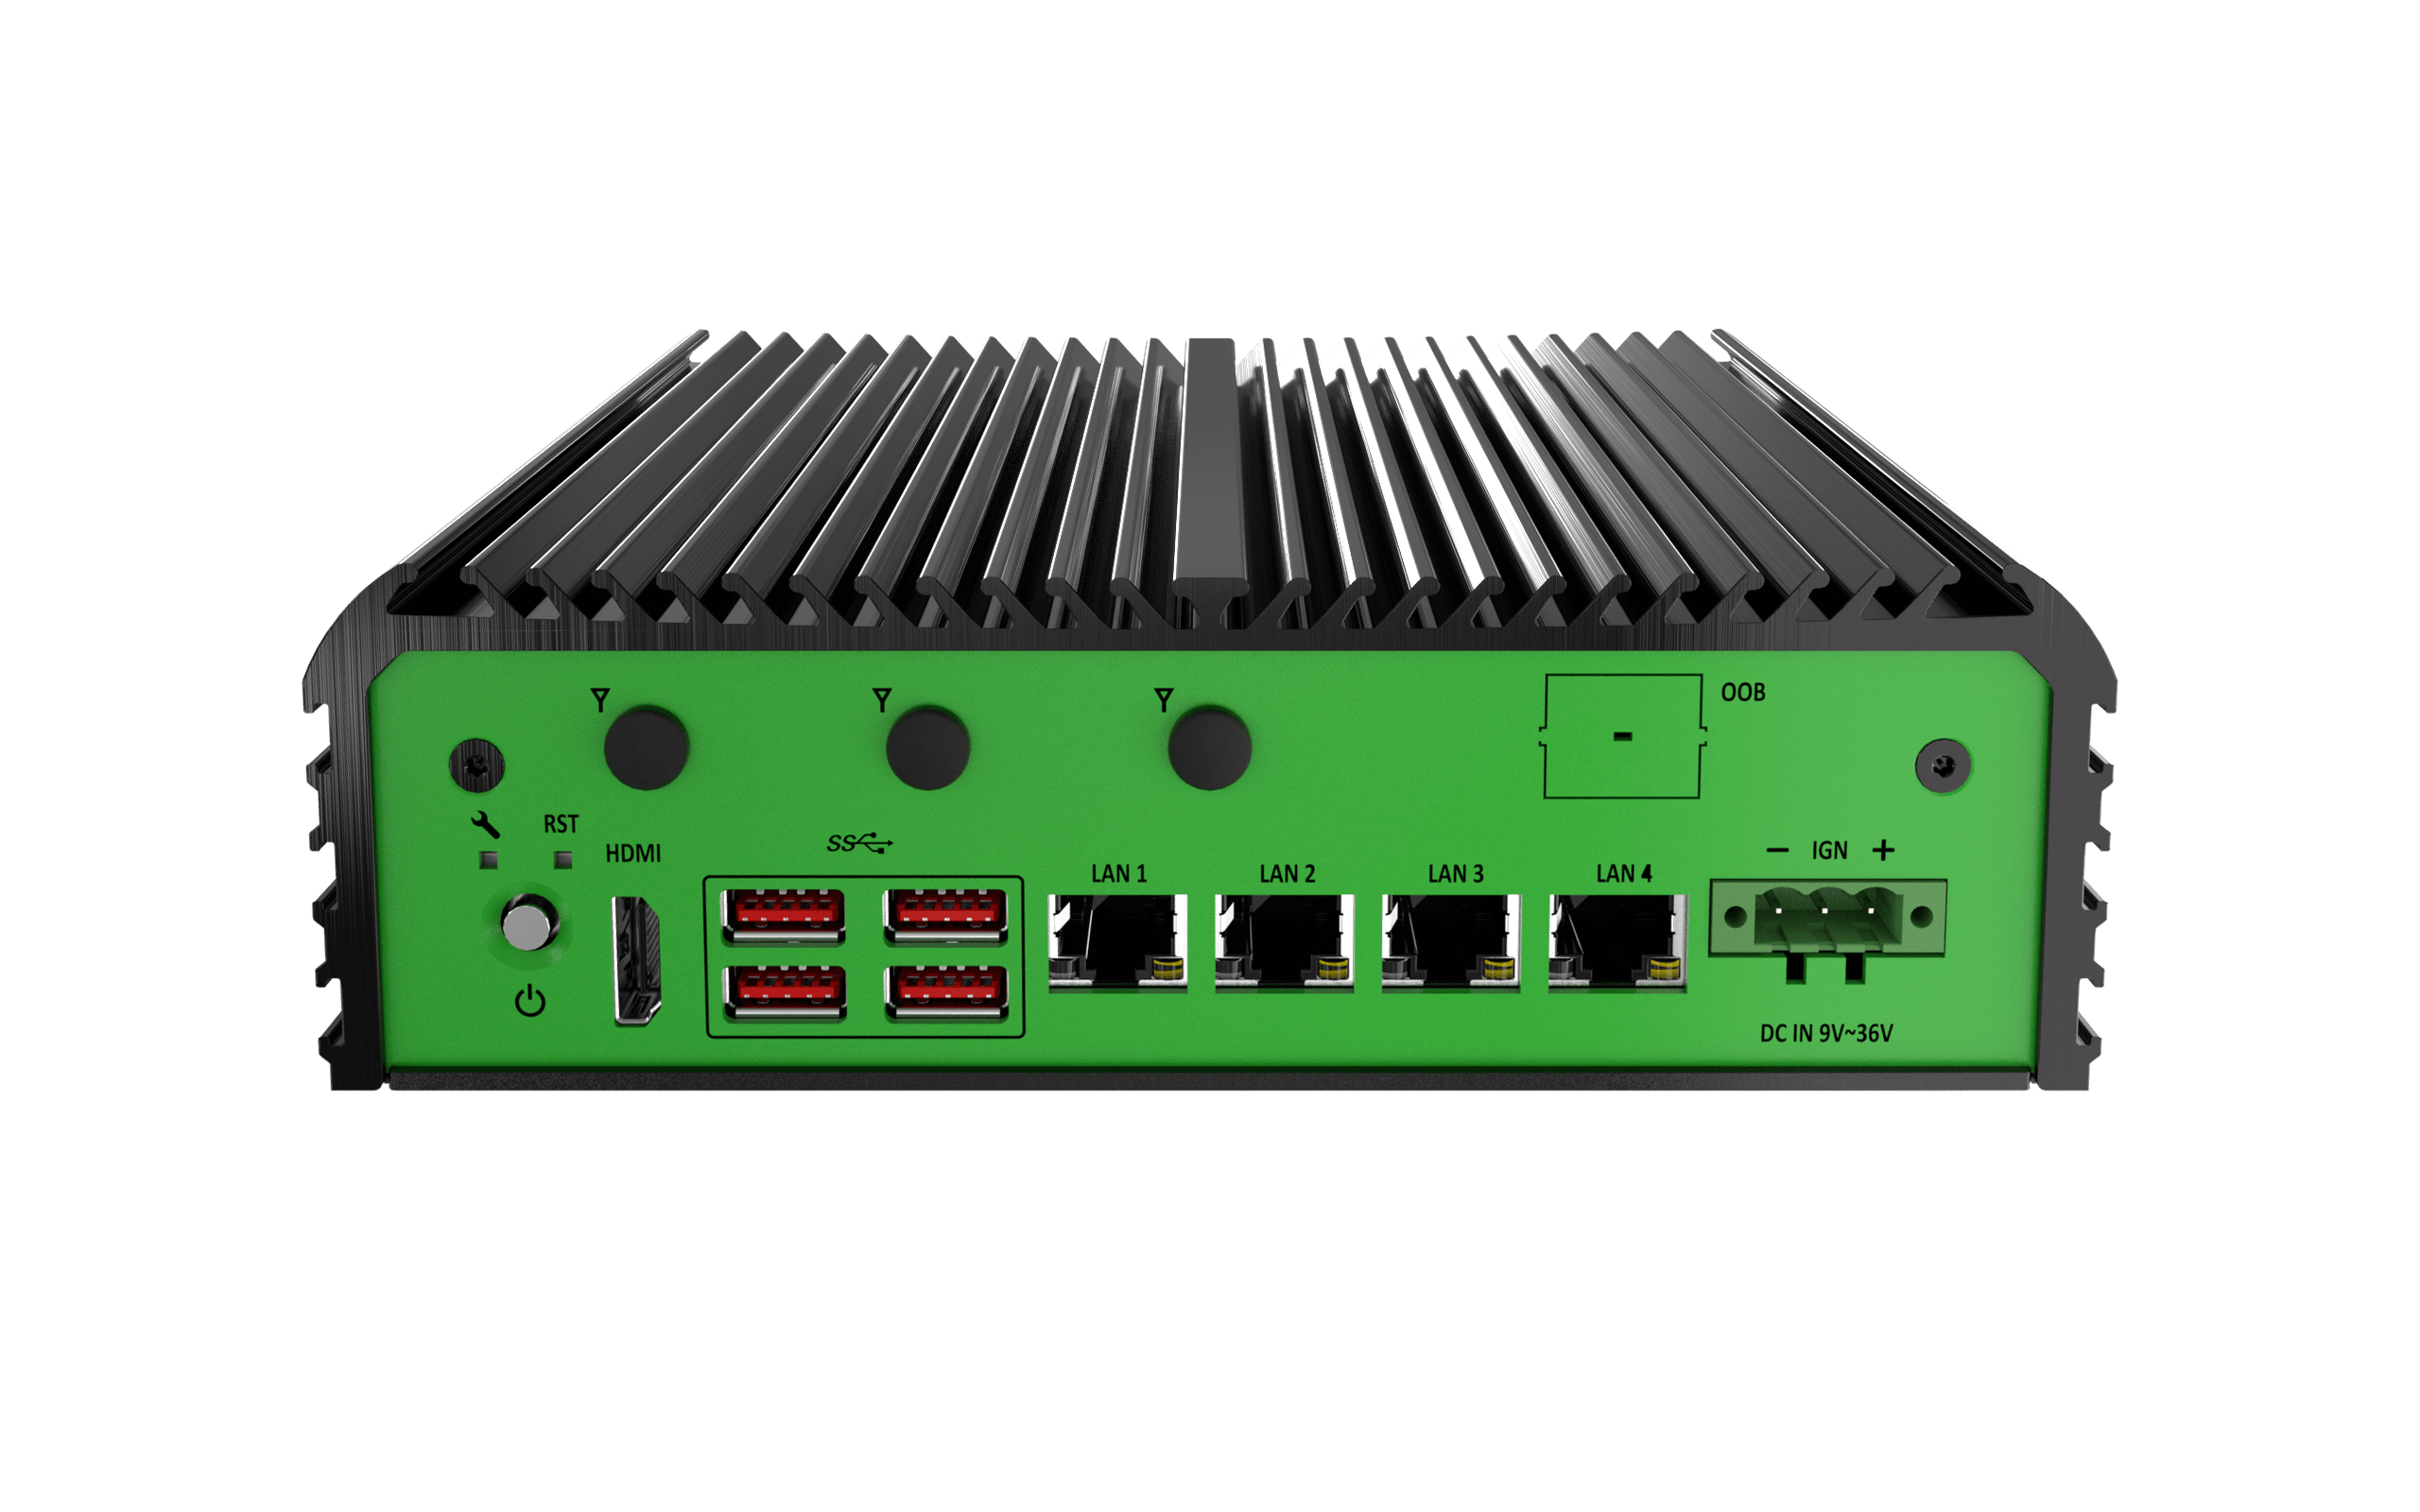


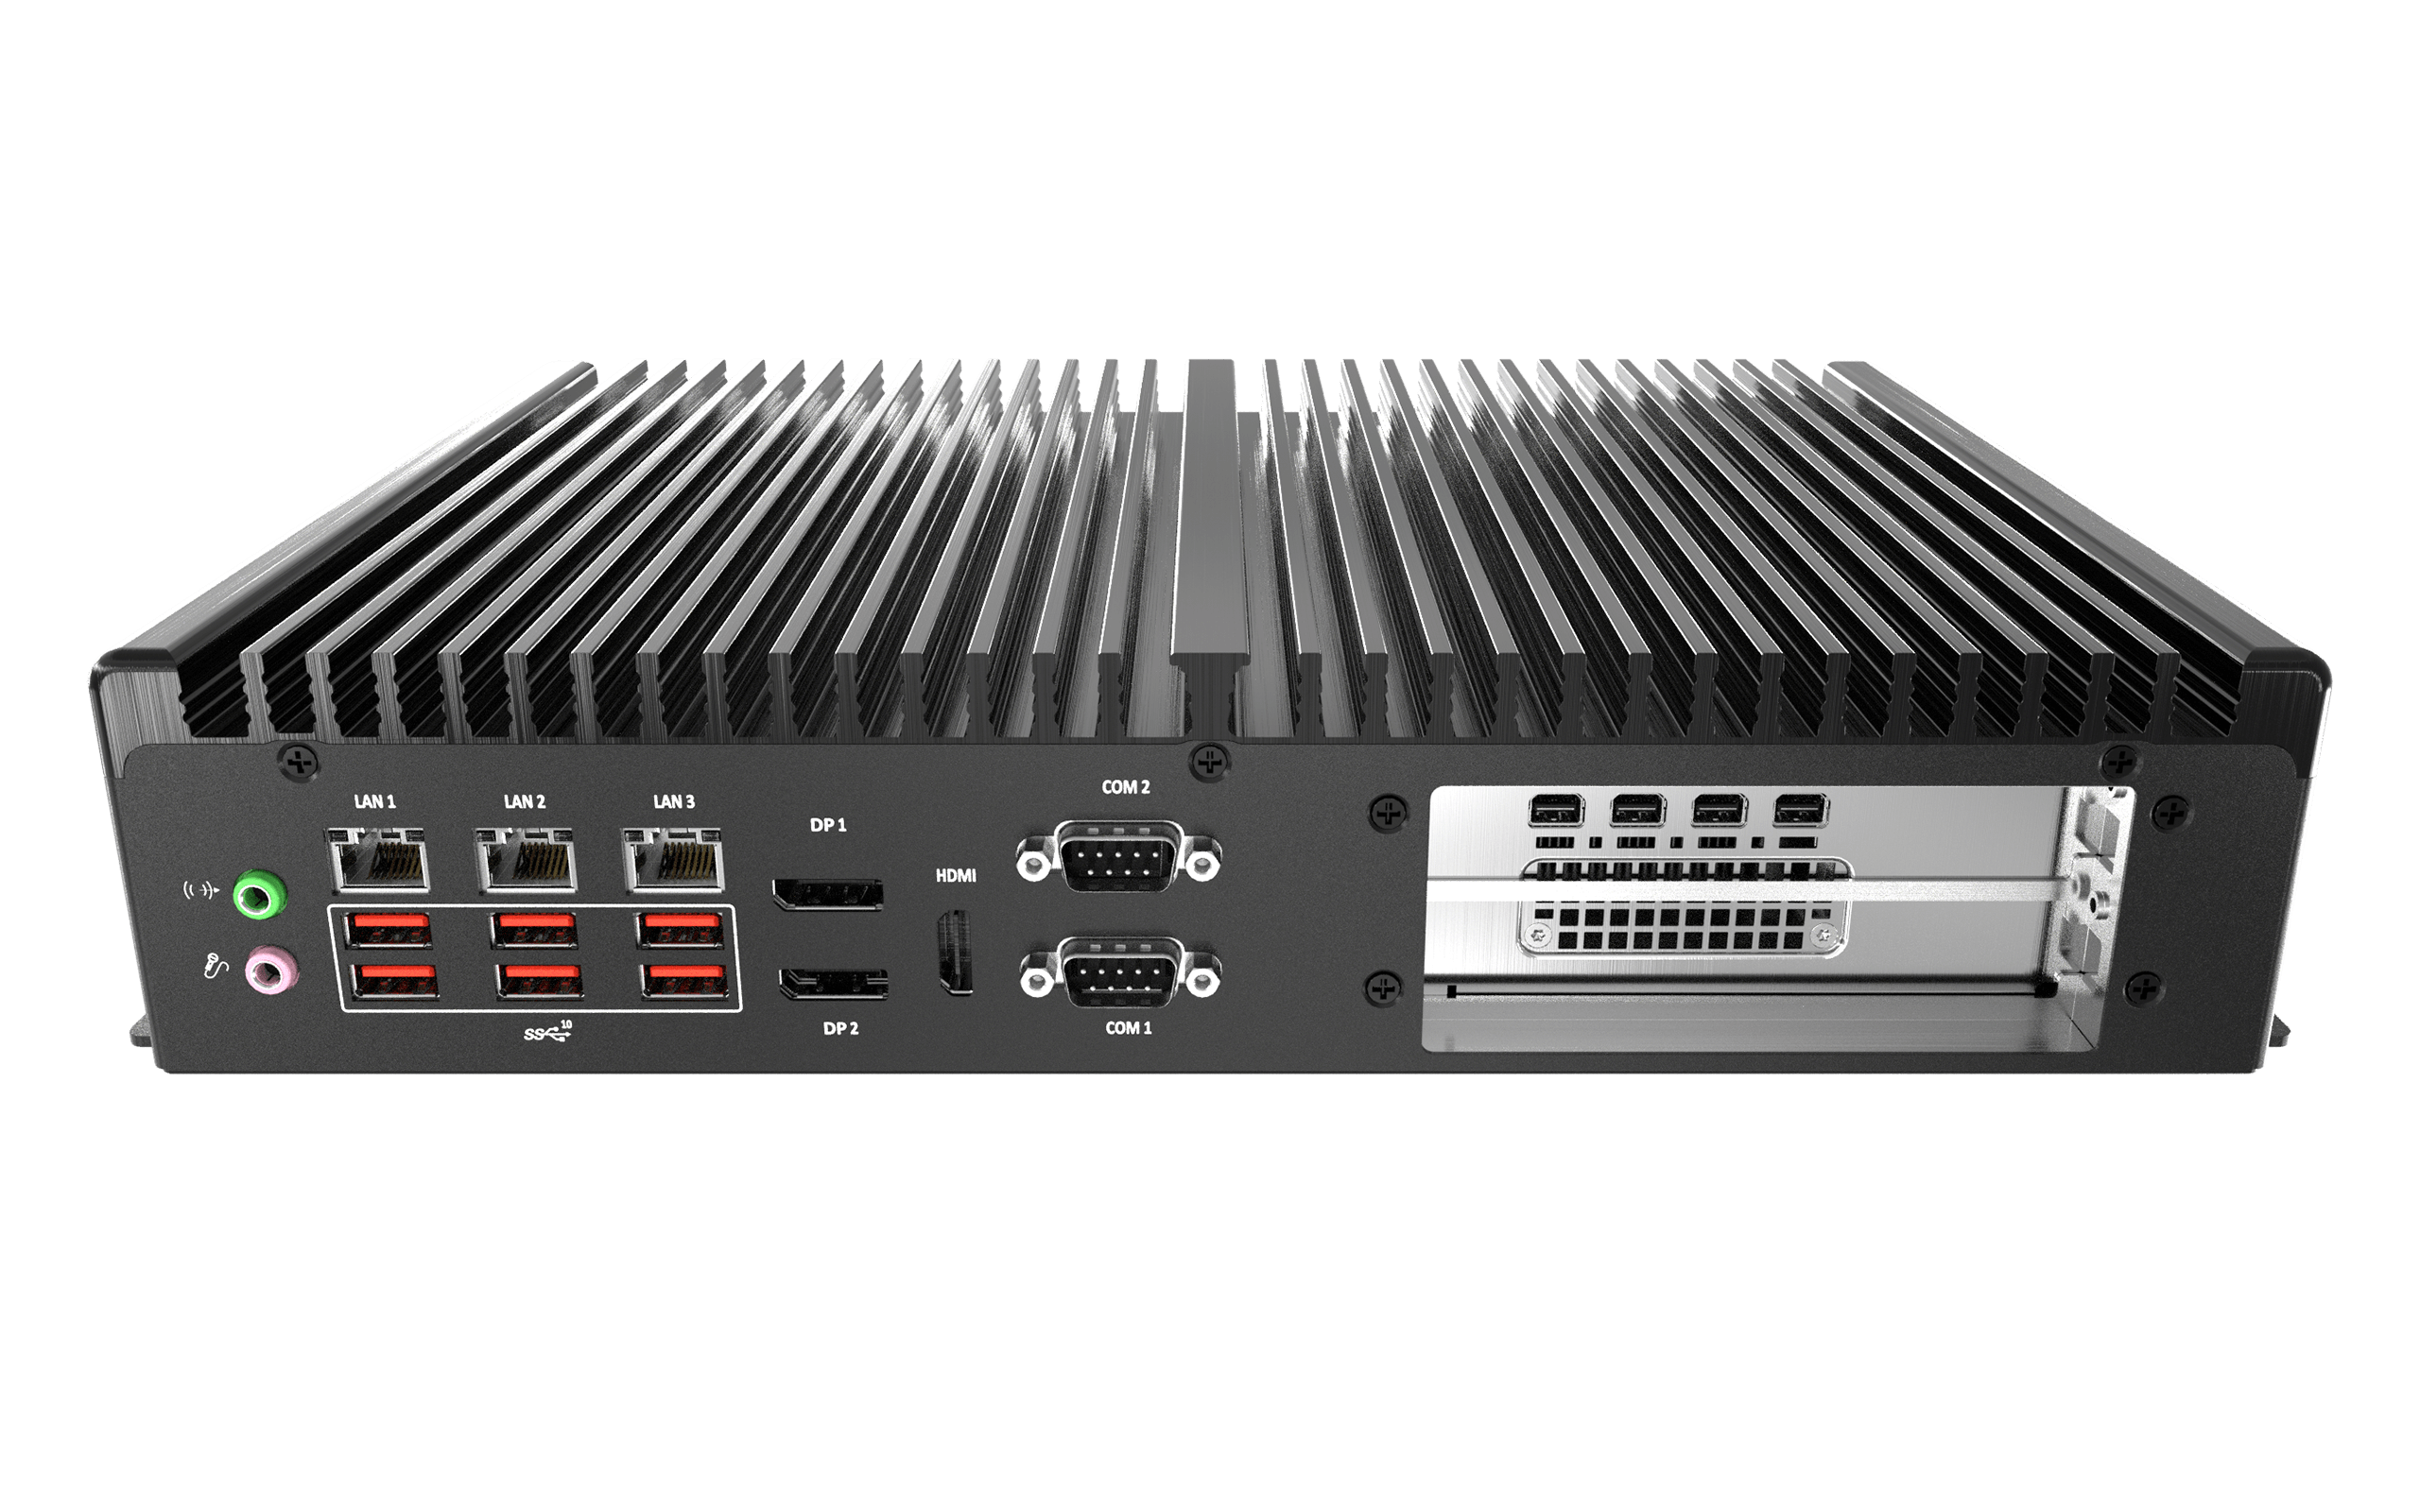

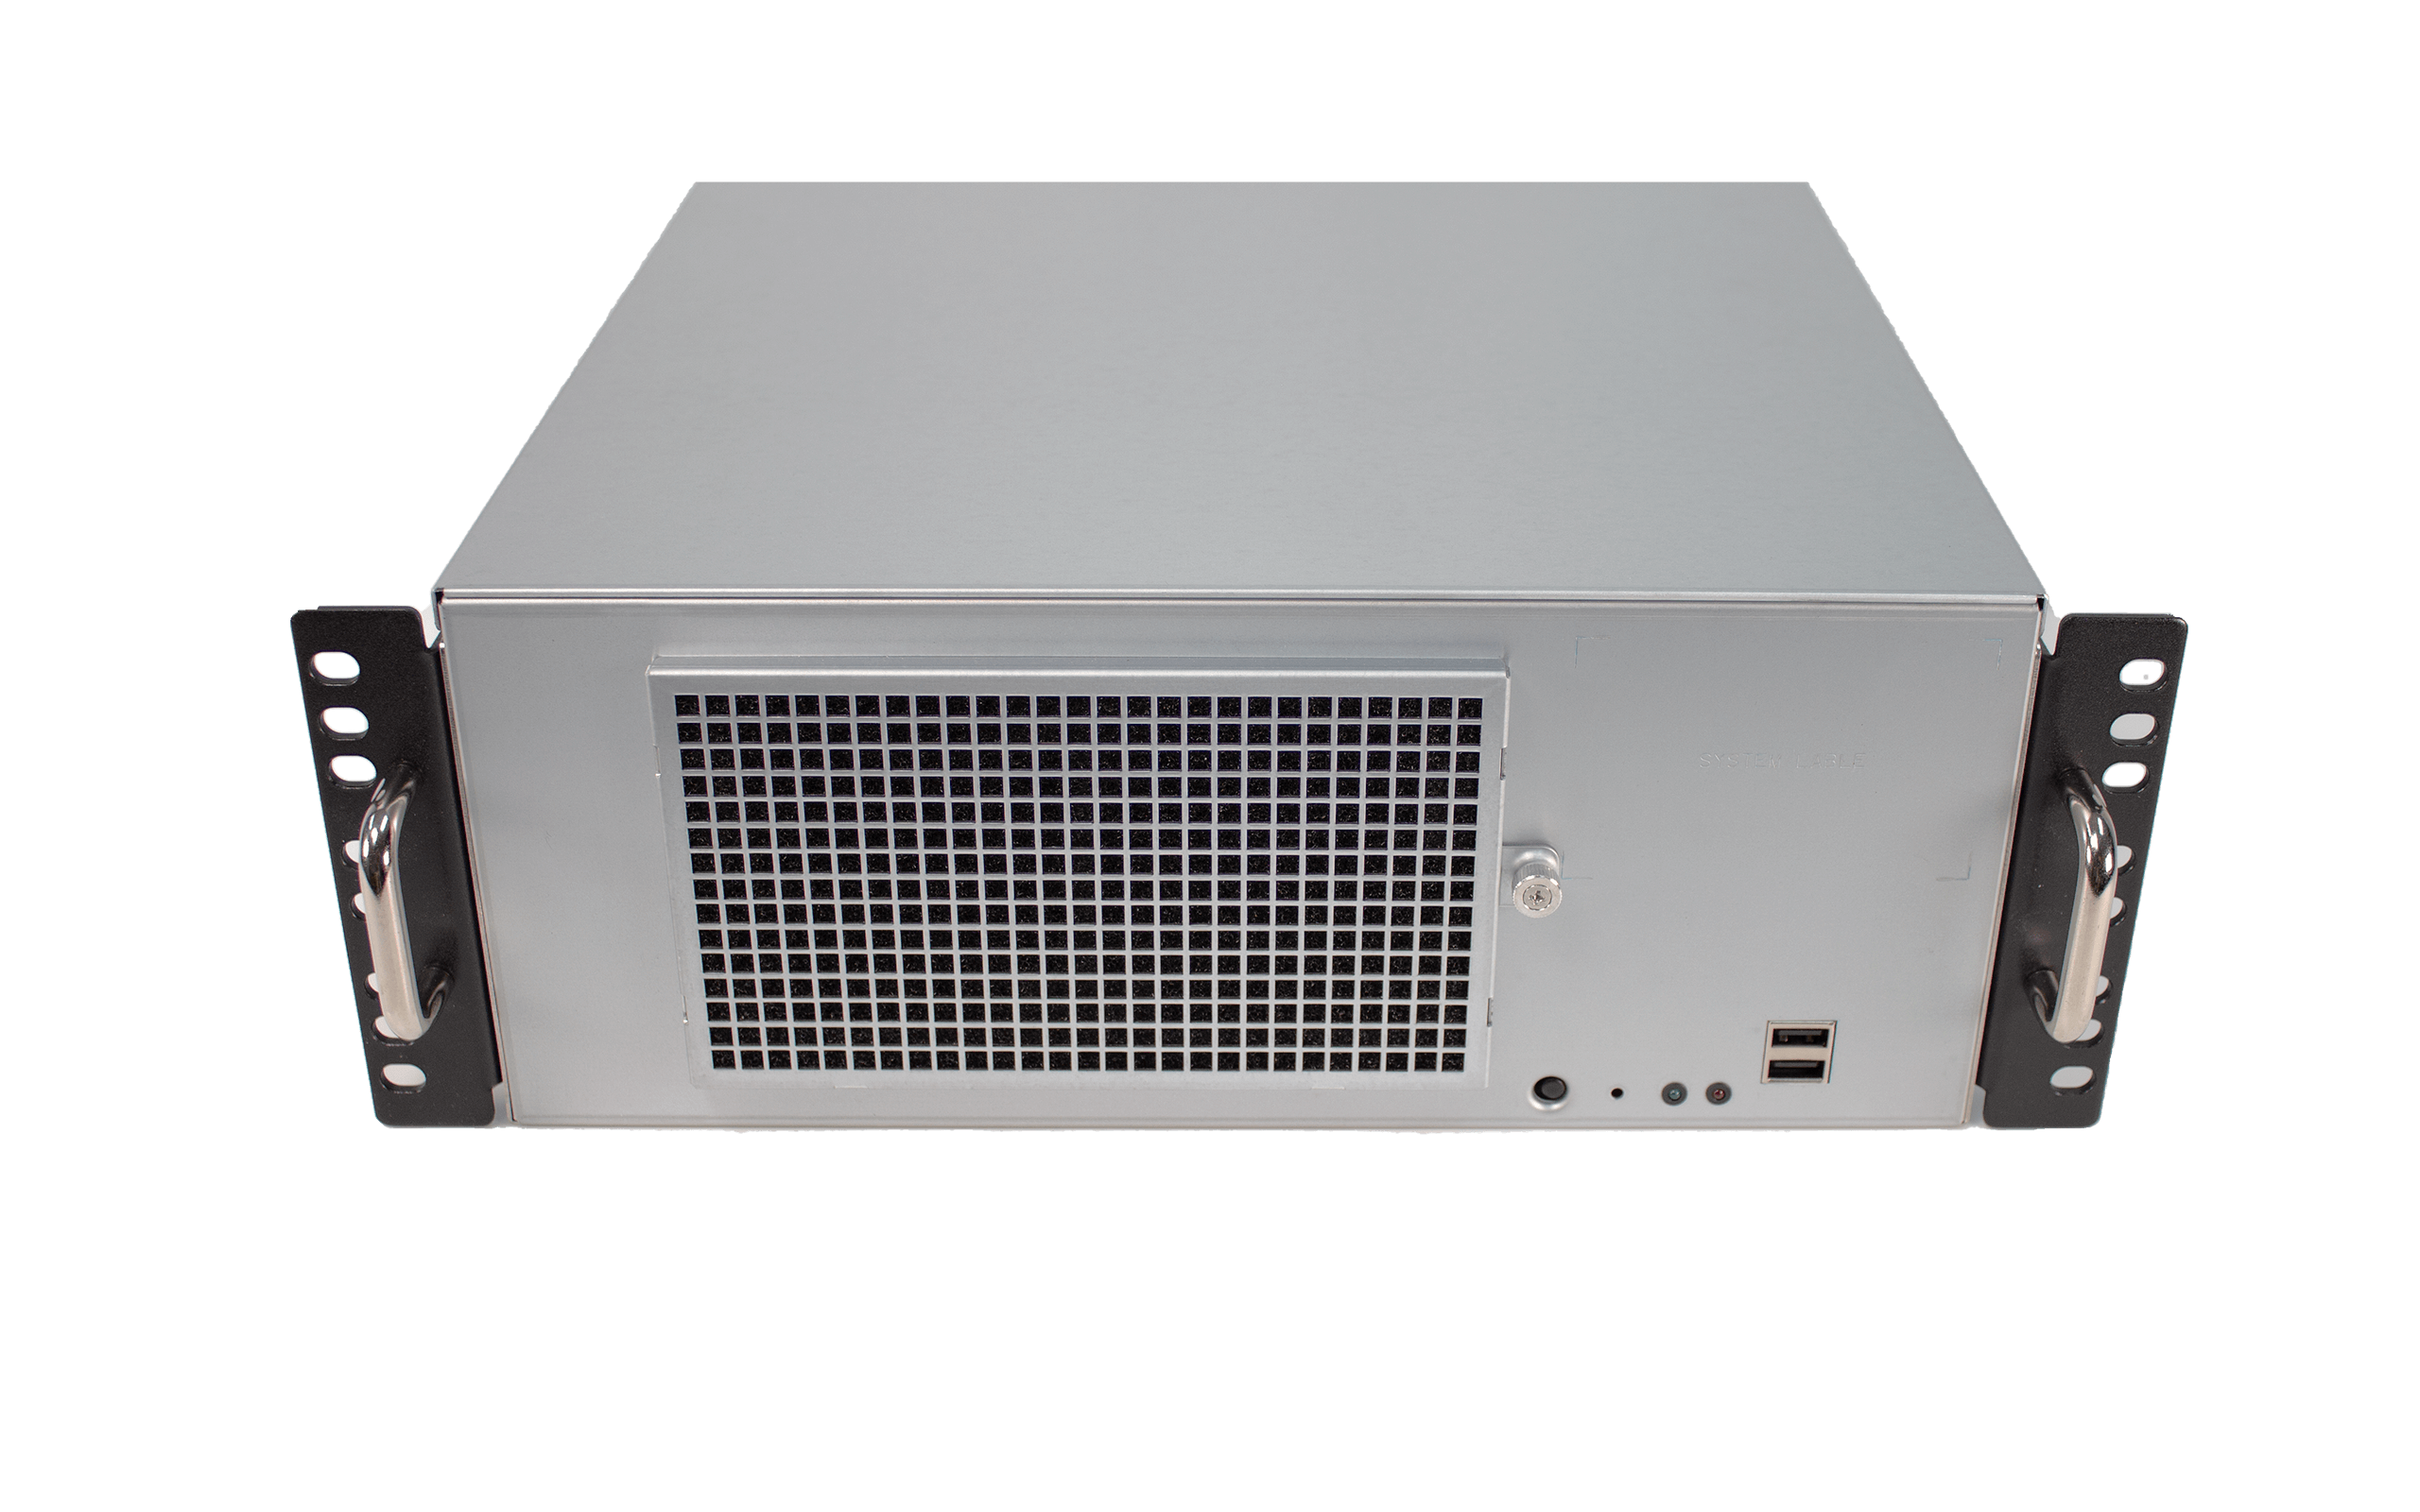


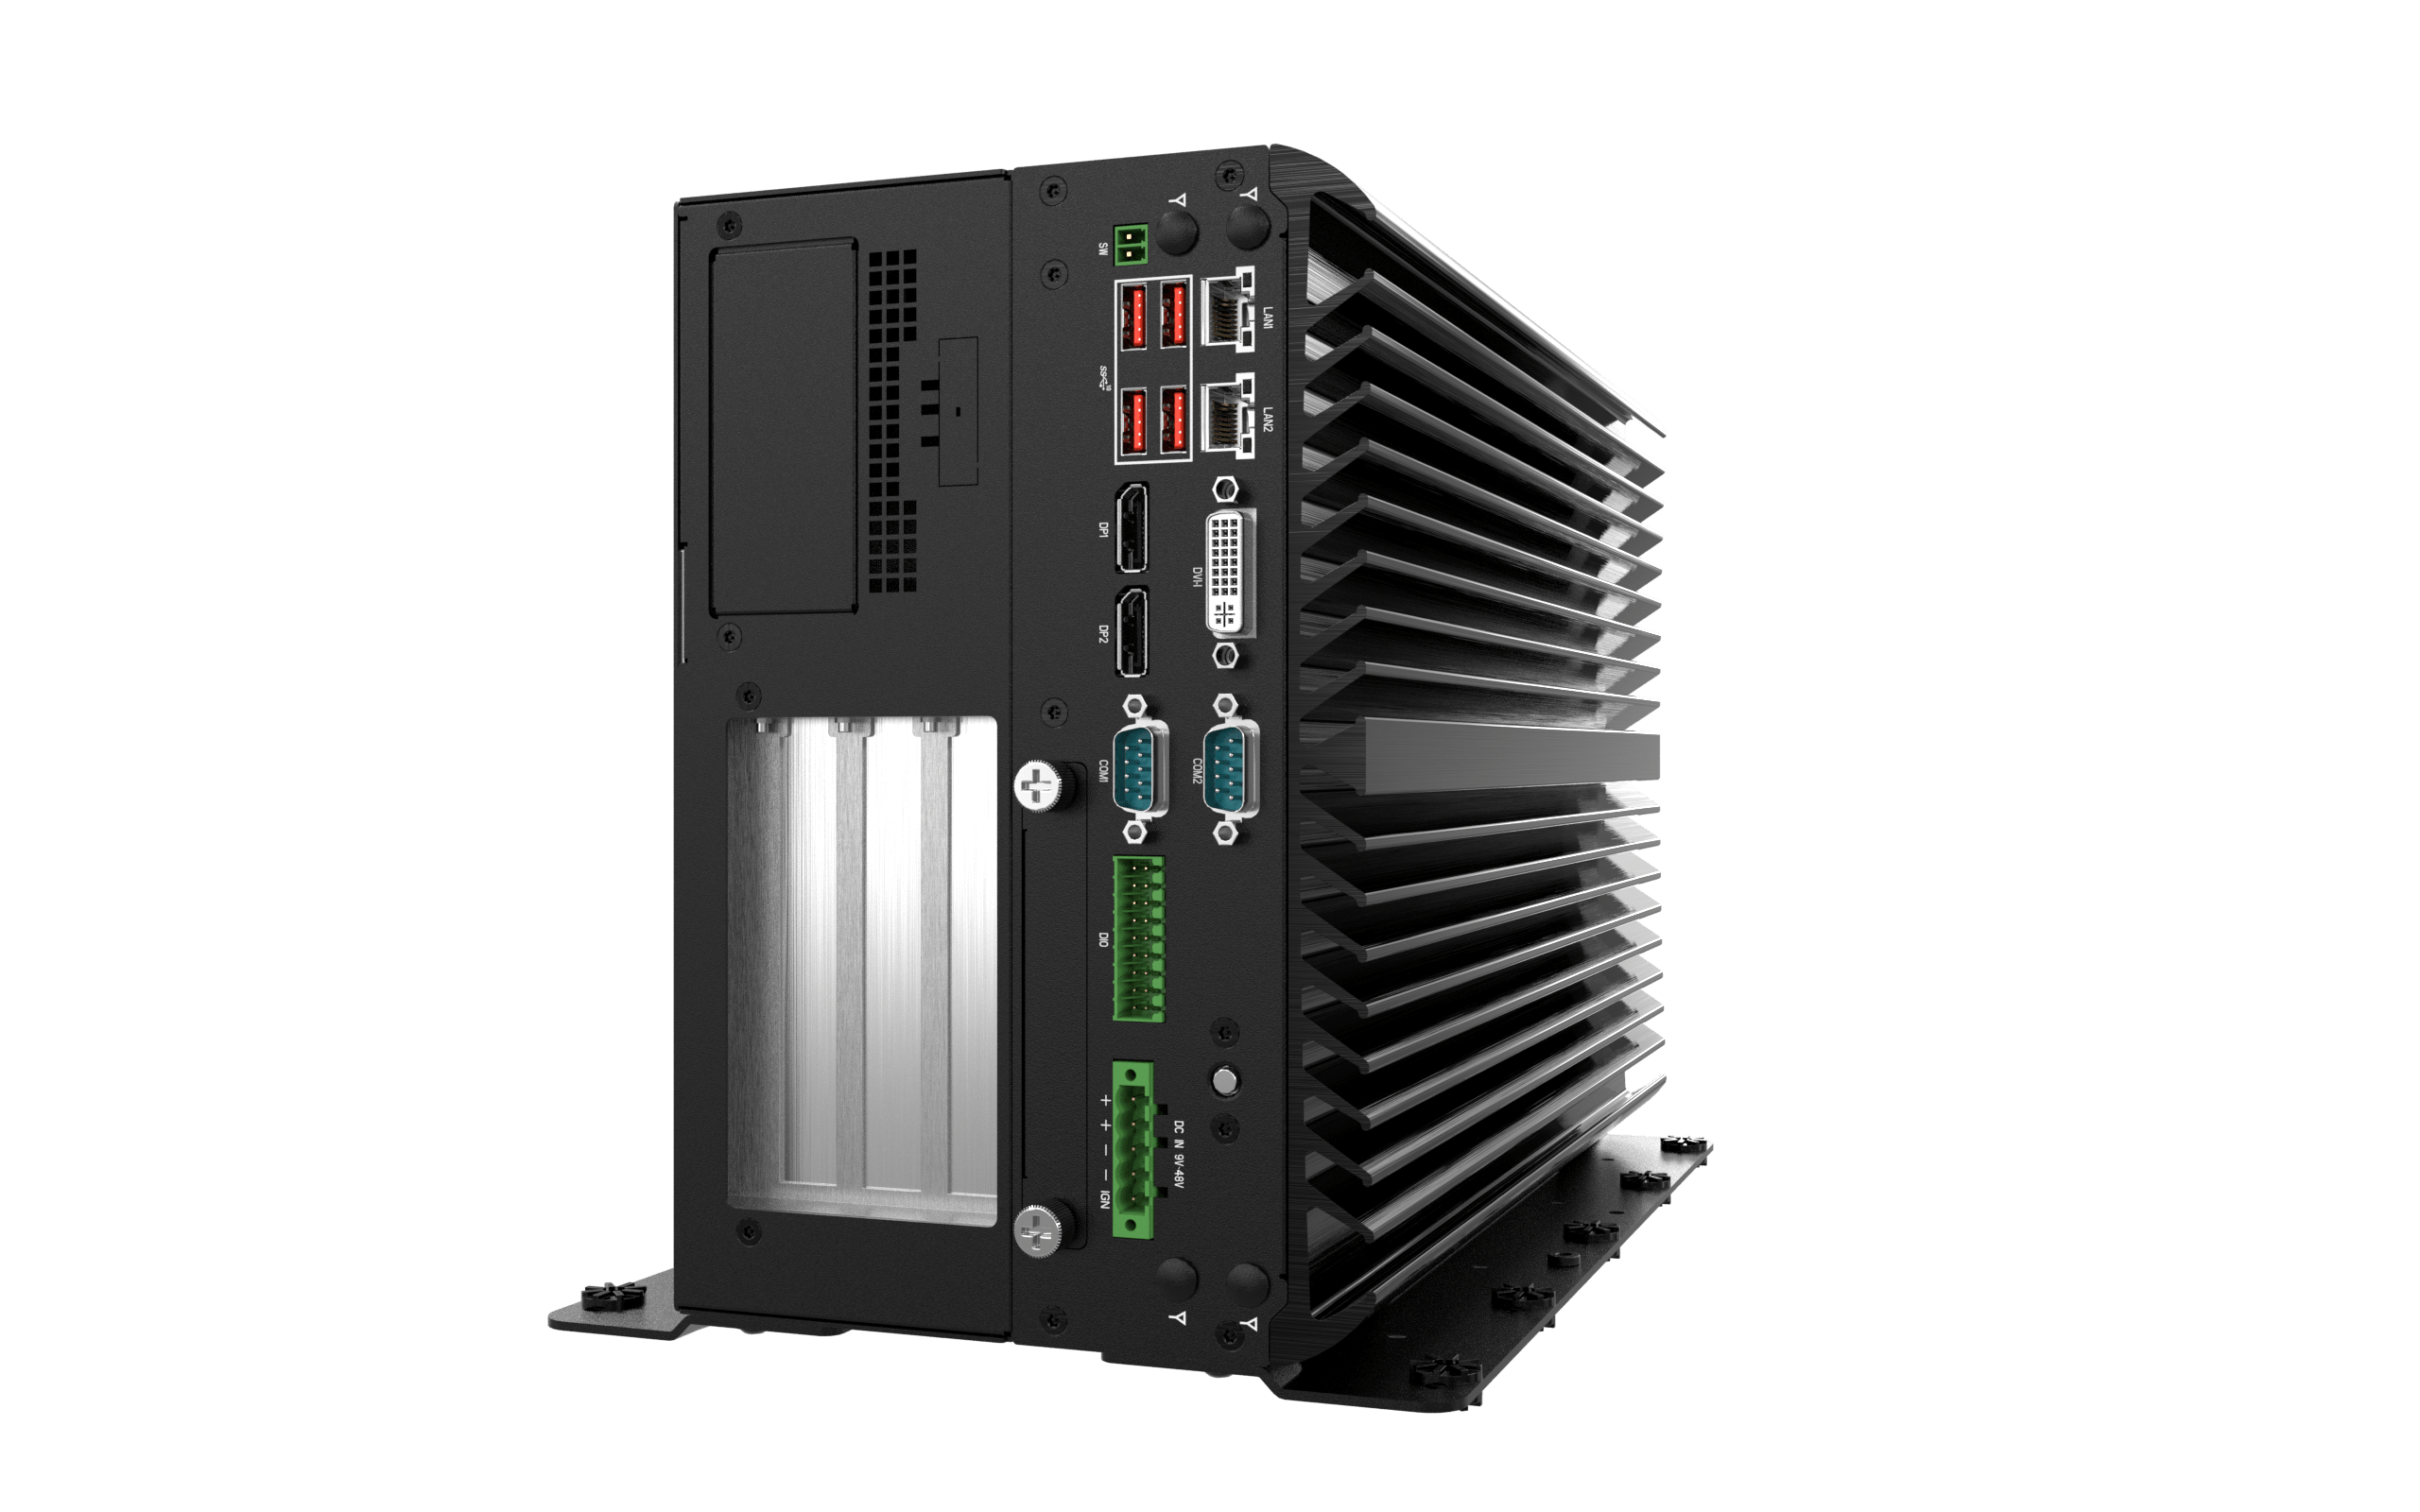
産業用GPUコンピュータの仕様
| モデル | エッジ連続体の位置 | プロセッサ | AIアクセラレーター | システム冷却 | 動作温度 | |
|---|---|---|---|---|---|---|


|
LLM-1U-RPL オンプレミスデータセンターエッジ |
オンプレミスデータセンターエッジ | 第13世代インテル® Core™ Eプロセッサー(TDP 65W) | - FHFL、デュアルスロットGPU - PCIe Gen 4 |
アクティブ | 0℃~35℃ |

|
VCO-6000-RPL マシンビジョンコンピュータ |
スペシャライズドエッジ | Intel® Core™ プロセッサー 第12世代/第13世代 (ADL/RPL) および第2シリーズ (BTL) (TDP 35W/45W) | - 2x FHFL、デュアルスロットGPU - PCIe Gen 4 |
アクティブ | -25℃~70℃ |

|
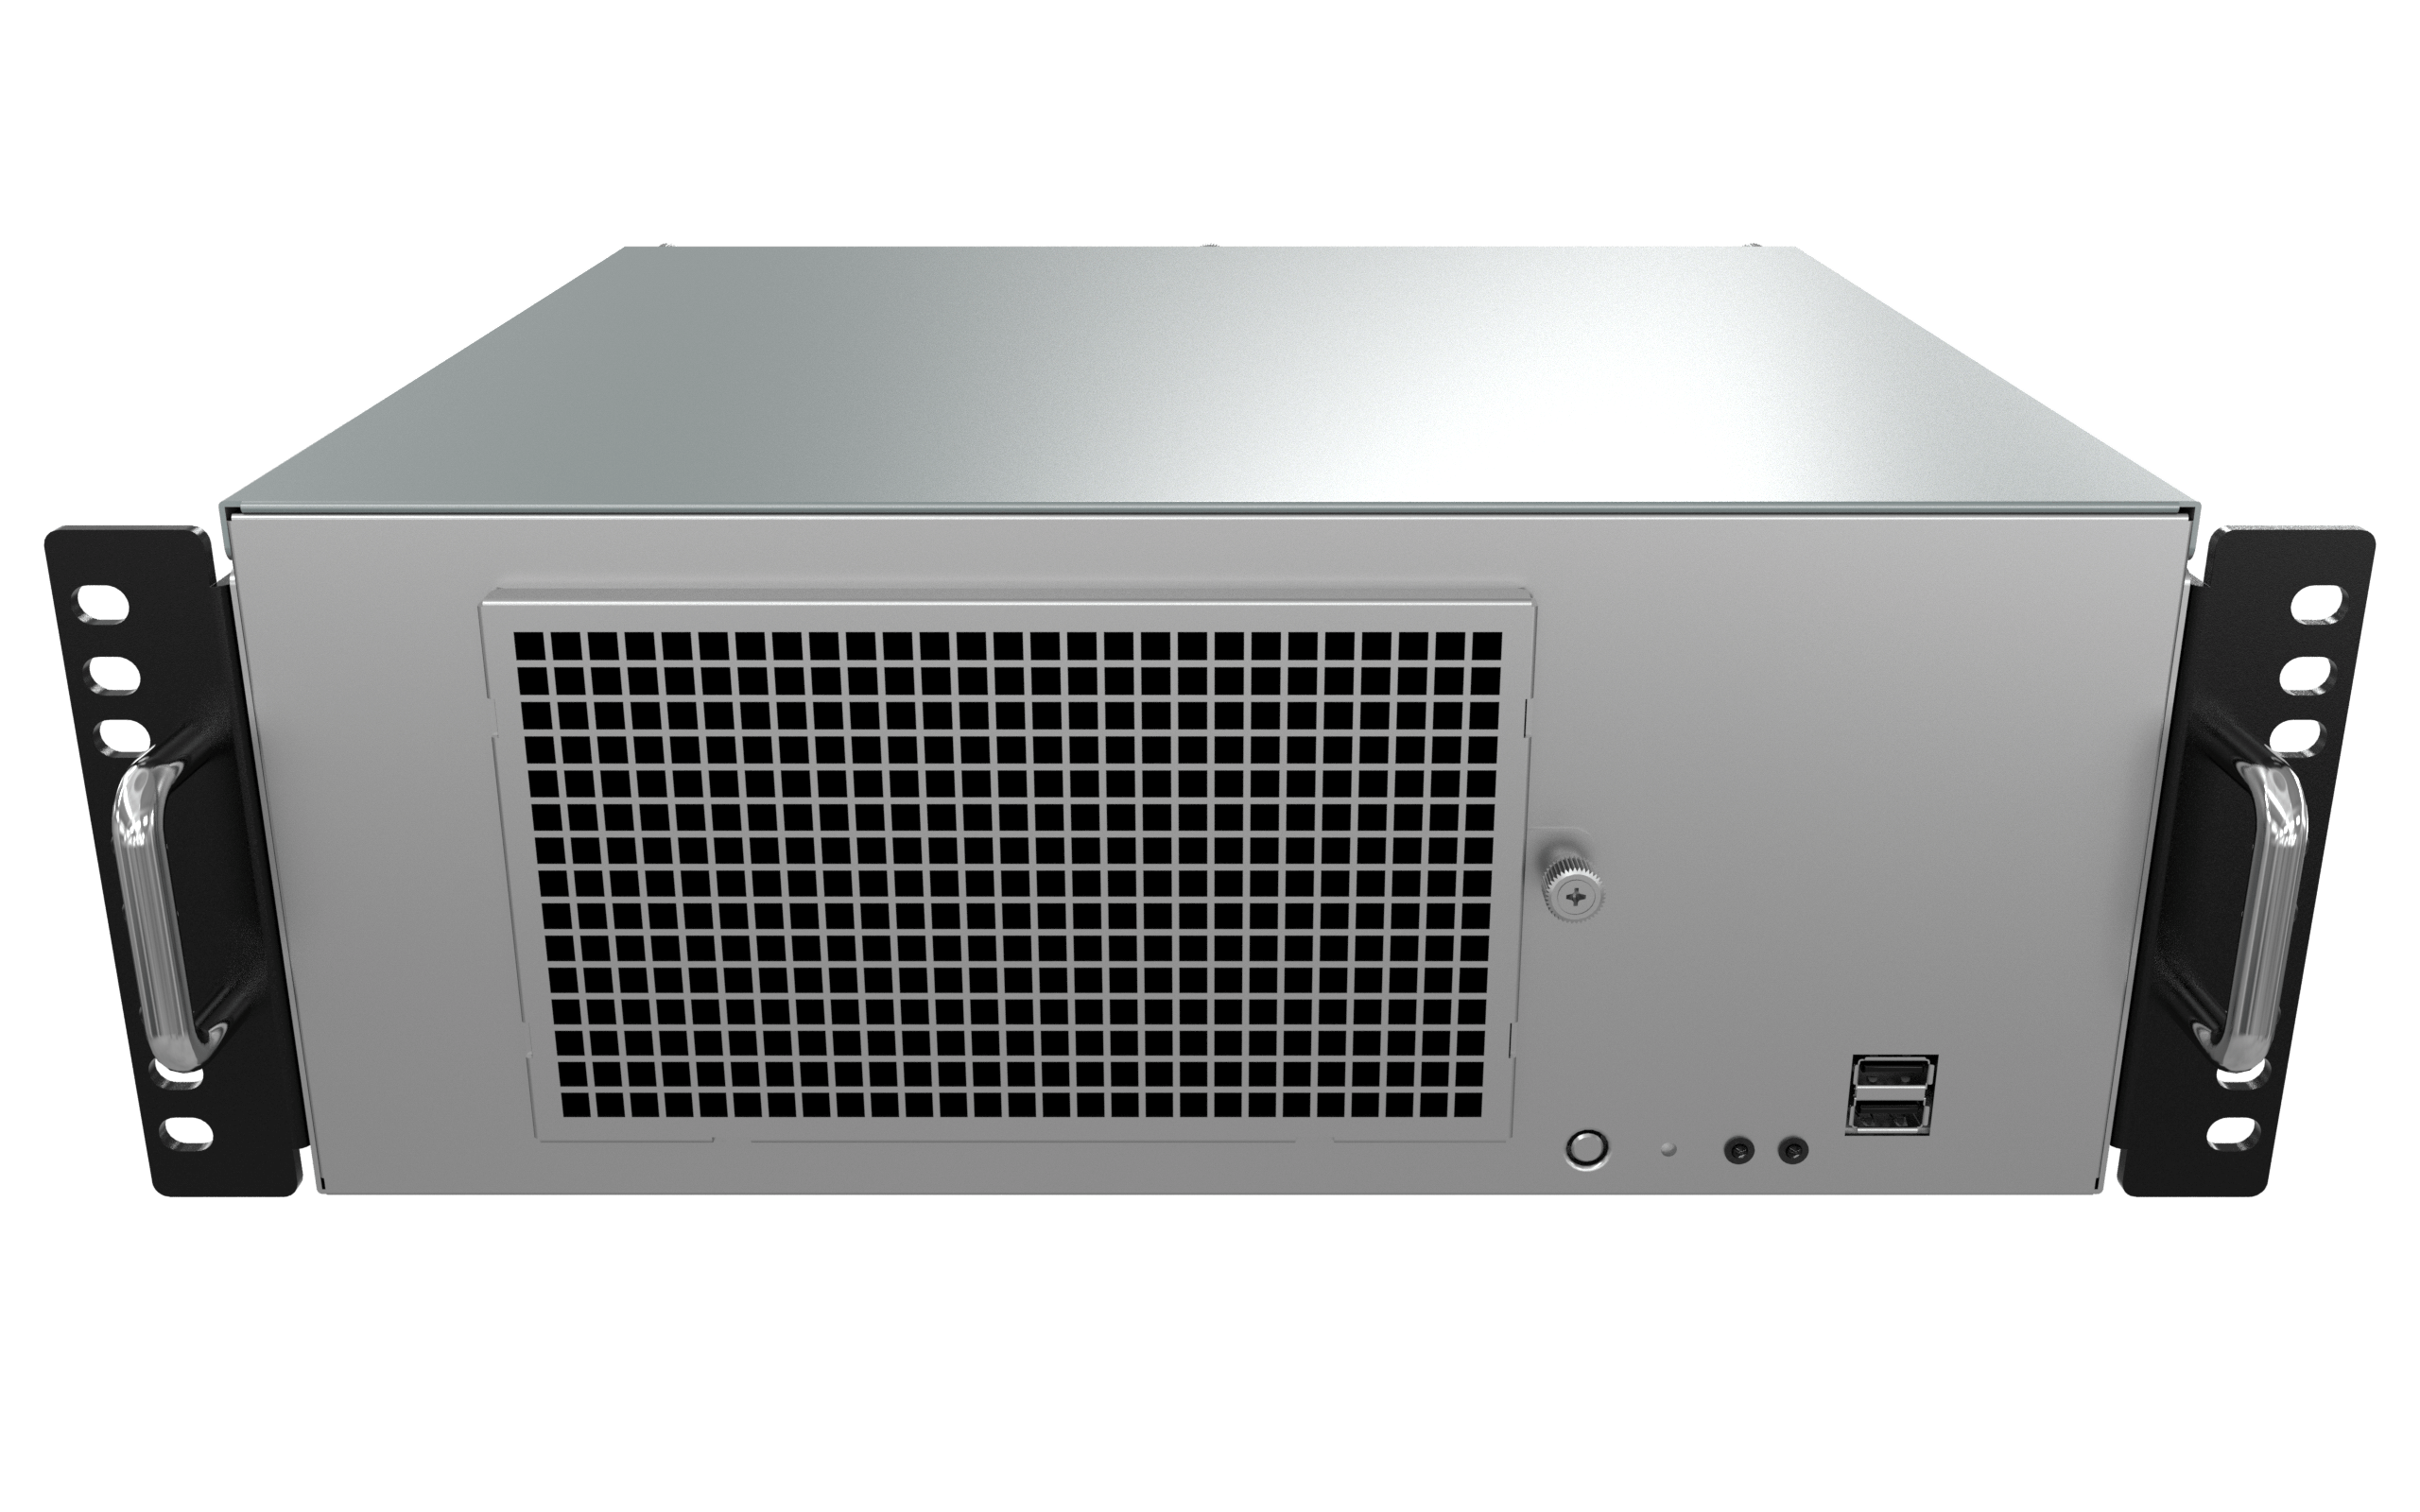
KCO-3000-RPL 3U産業用ファン付きコンピュータ |
スペシャライズドエッジ | 第13世代インテル® Core™ Eプロセッサー(TDP 65W) | - FHFL対応デュアルスロットGPU×2 - PCIe Gen 5 |
アクティブ | 0℃~60℃ |

|
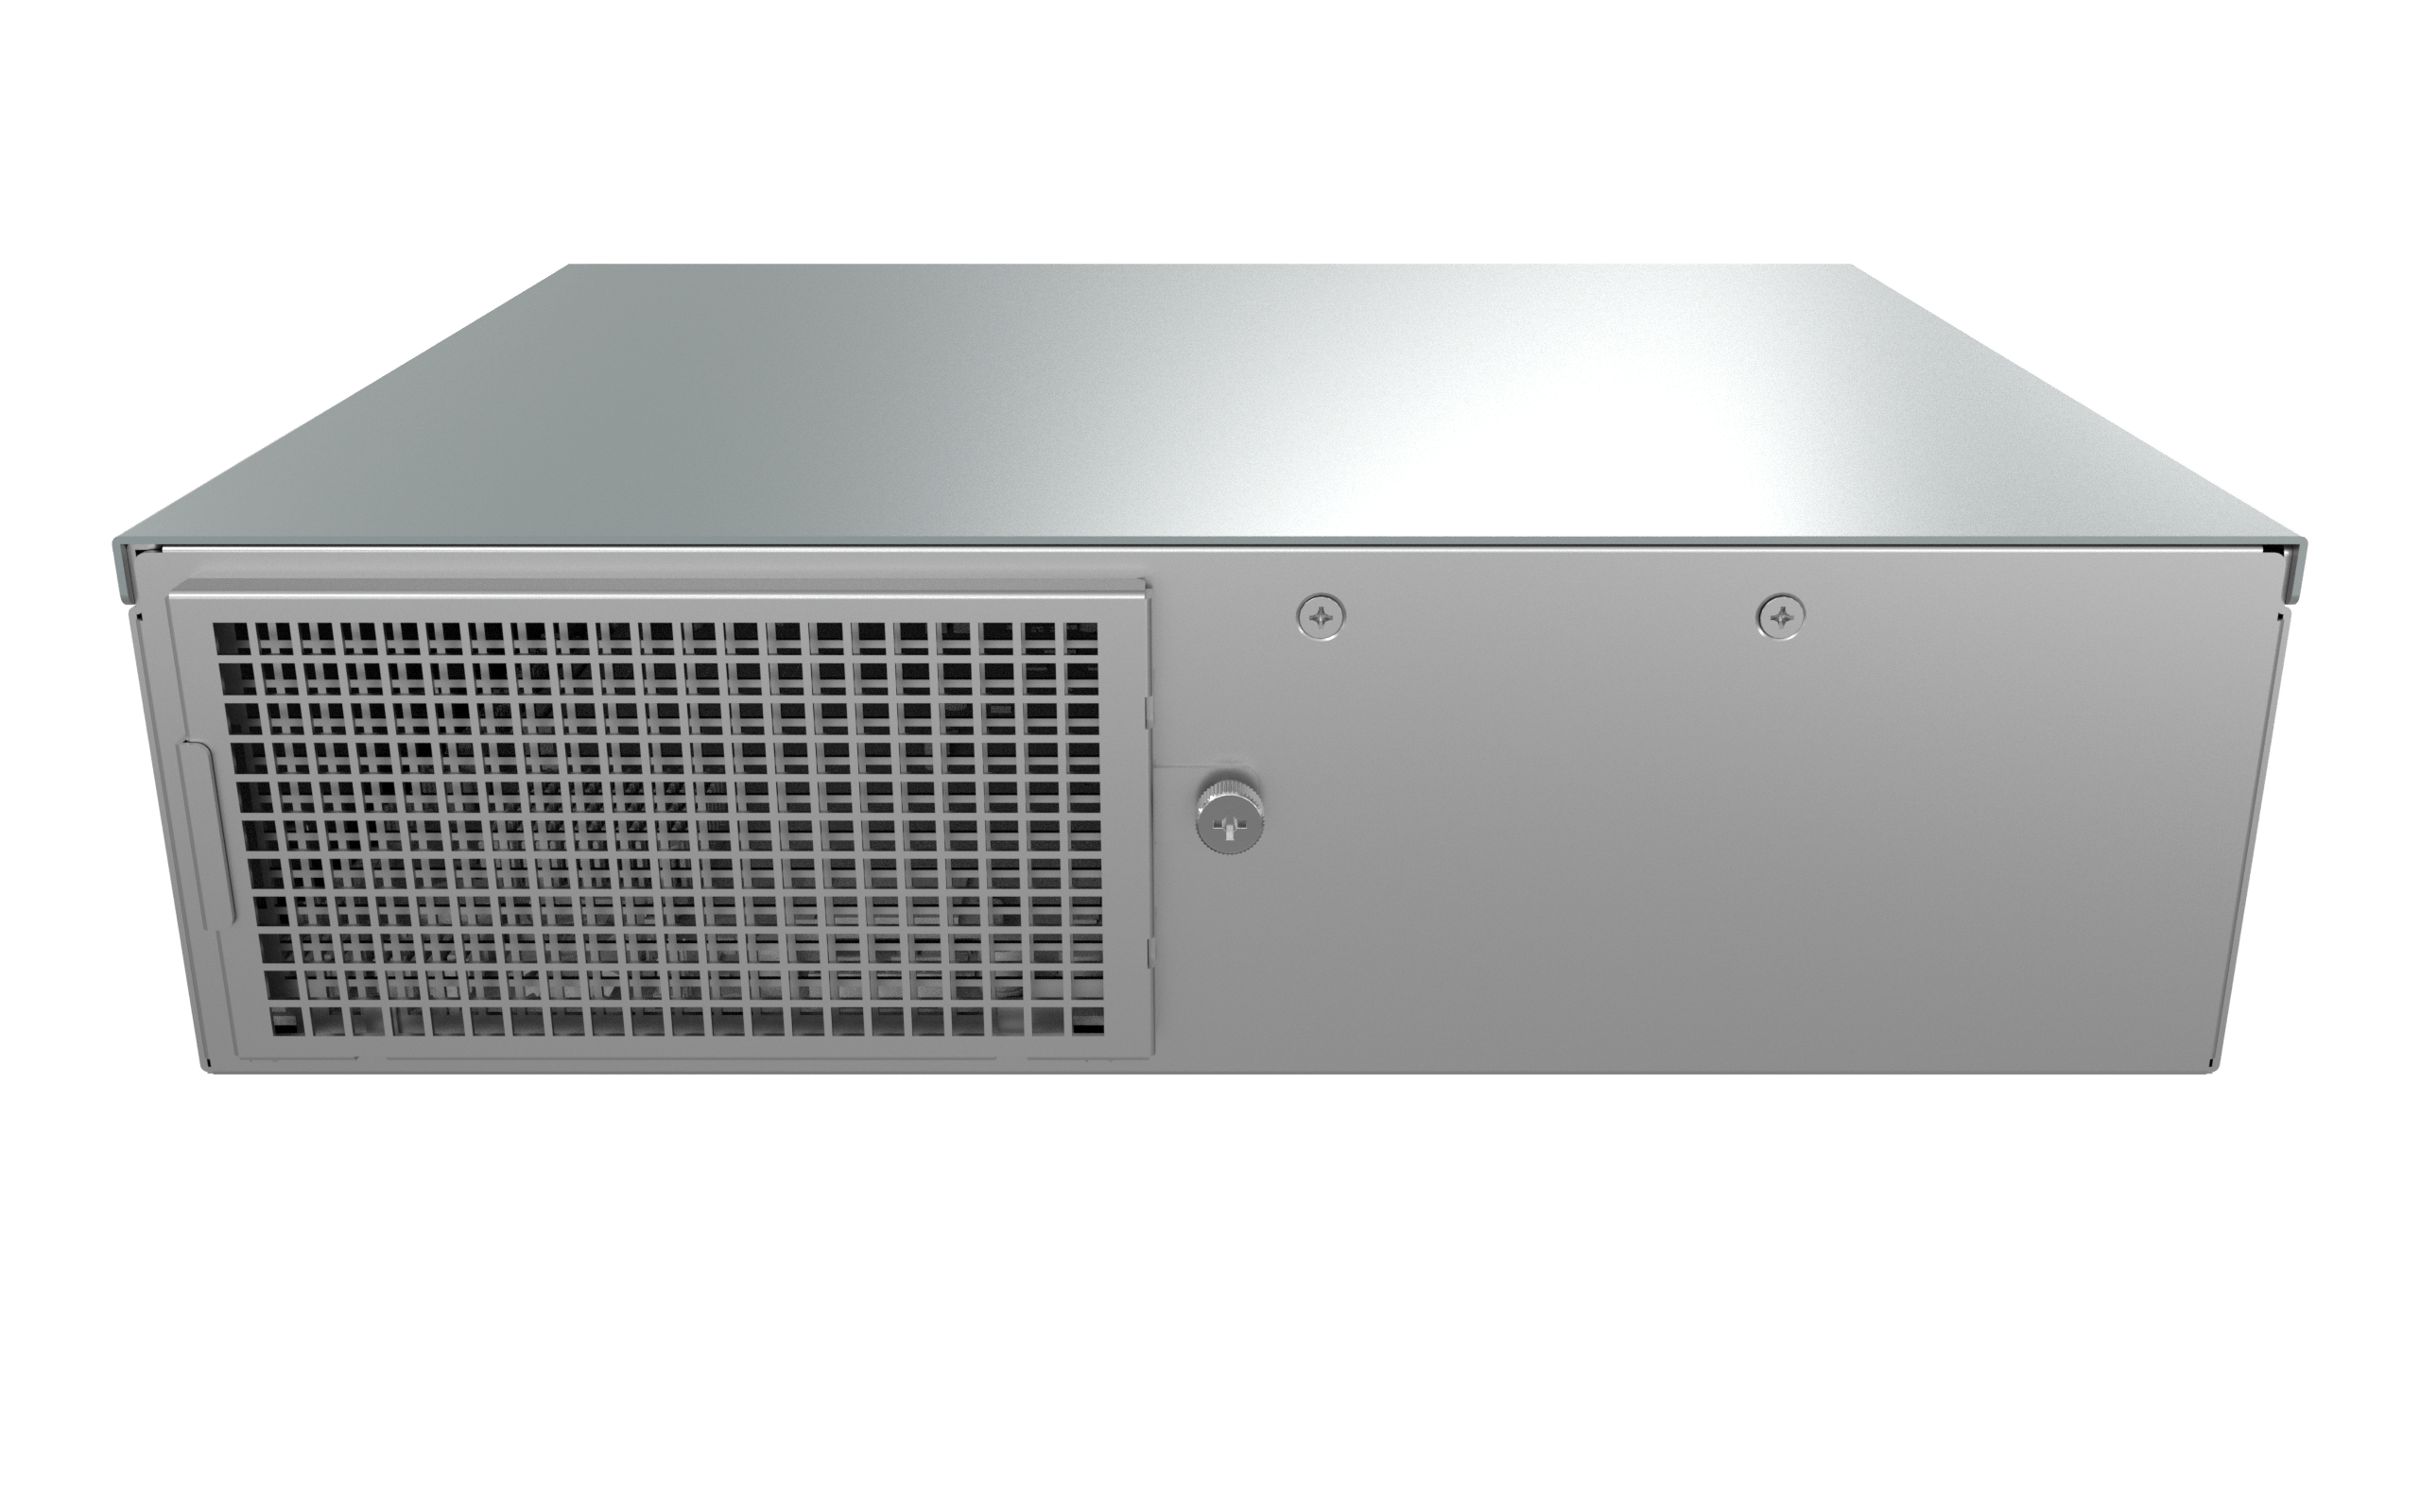
KCO-2000-RPL 2U産業用ファン付きコンピュータ |
スペシャライズドエッジ | 第13世代インテル® Core™ Eプロセッサー(TDP 65W) | - LP、デュアルスロットGPU - PCIe Gen 5 |
アクティブ | 0℃~60℃ |

|
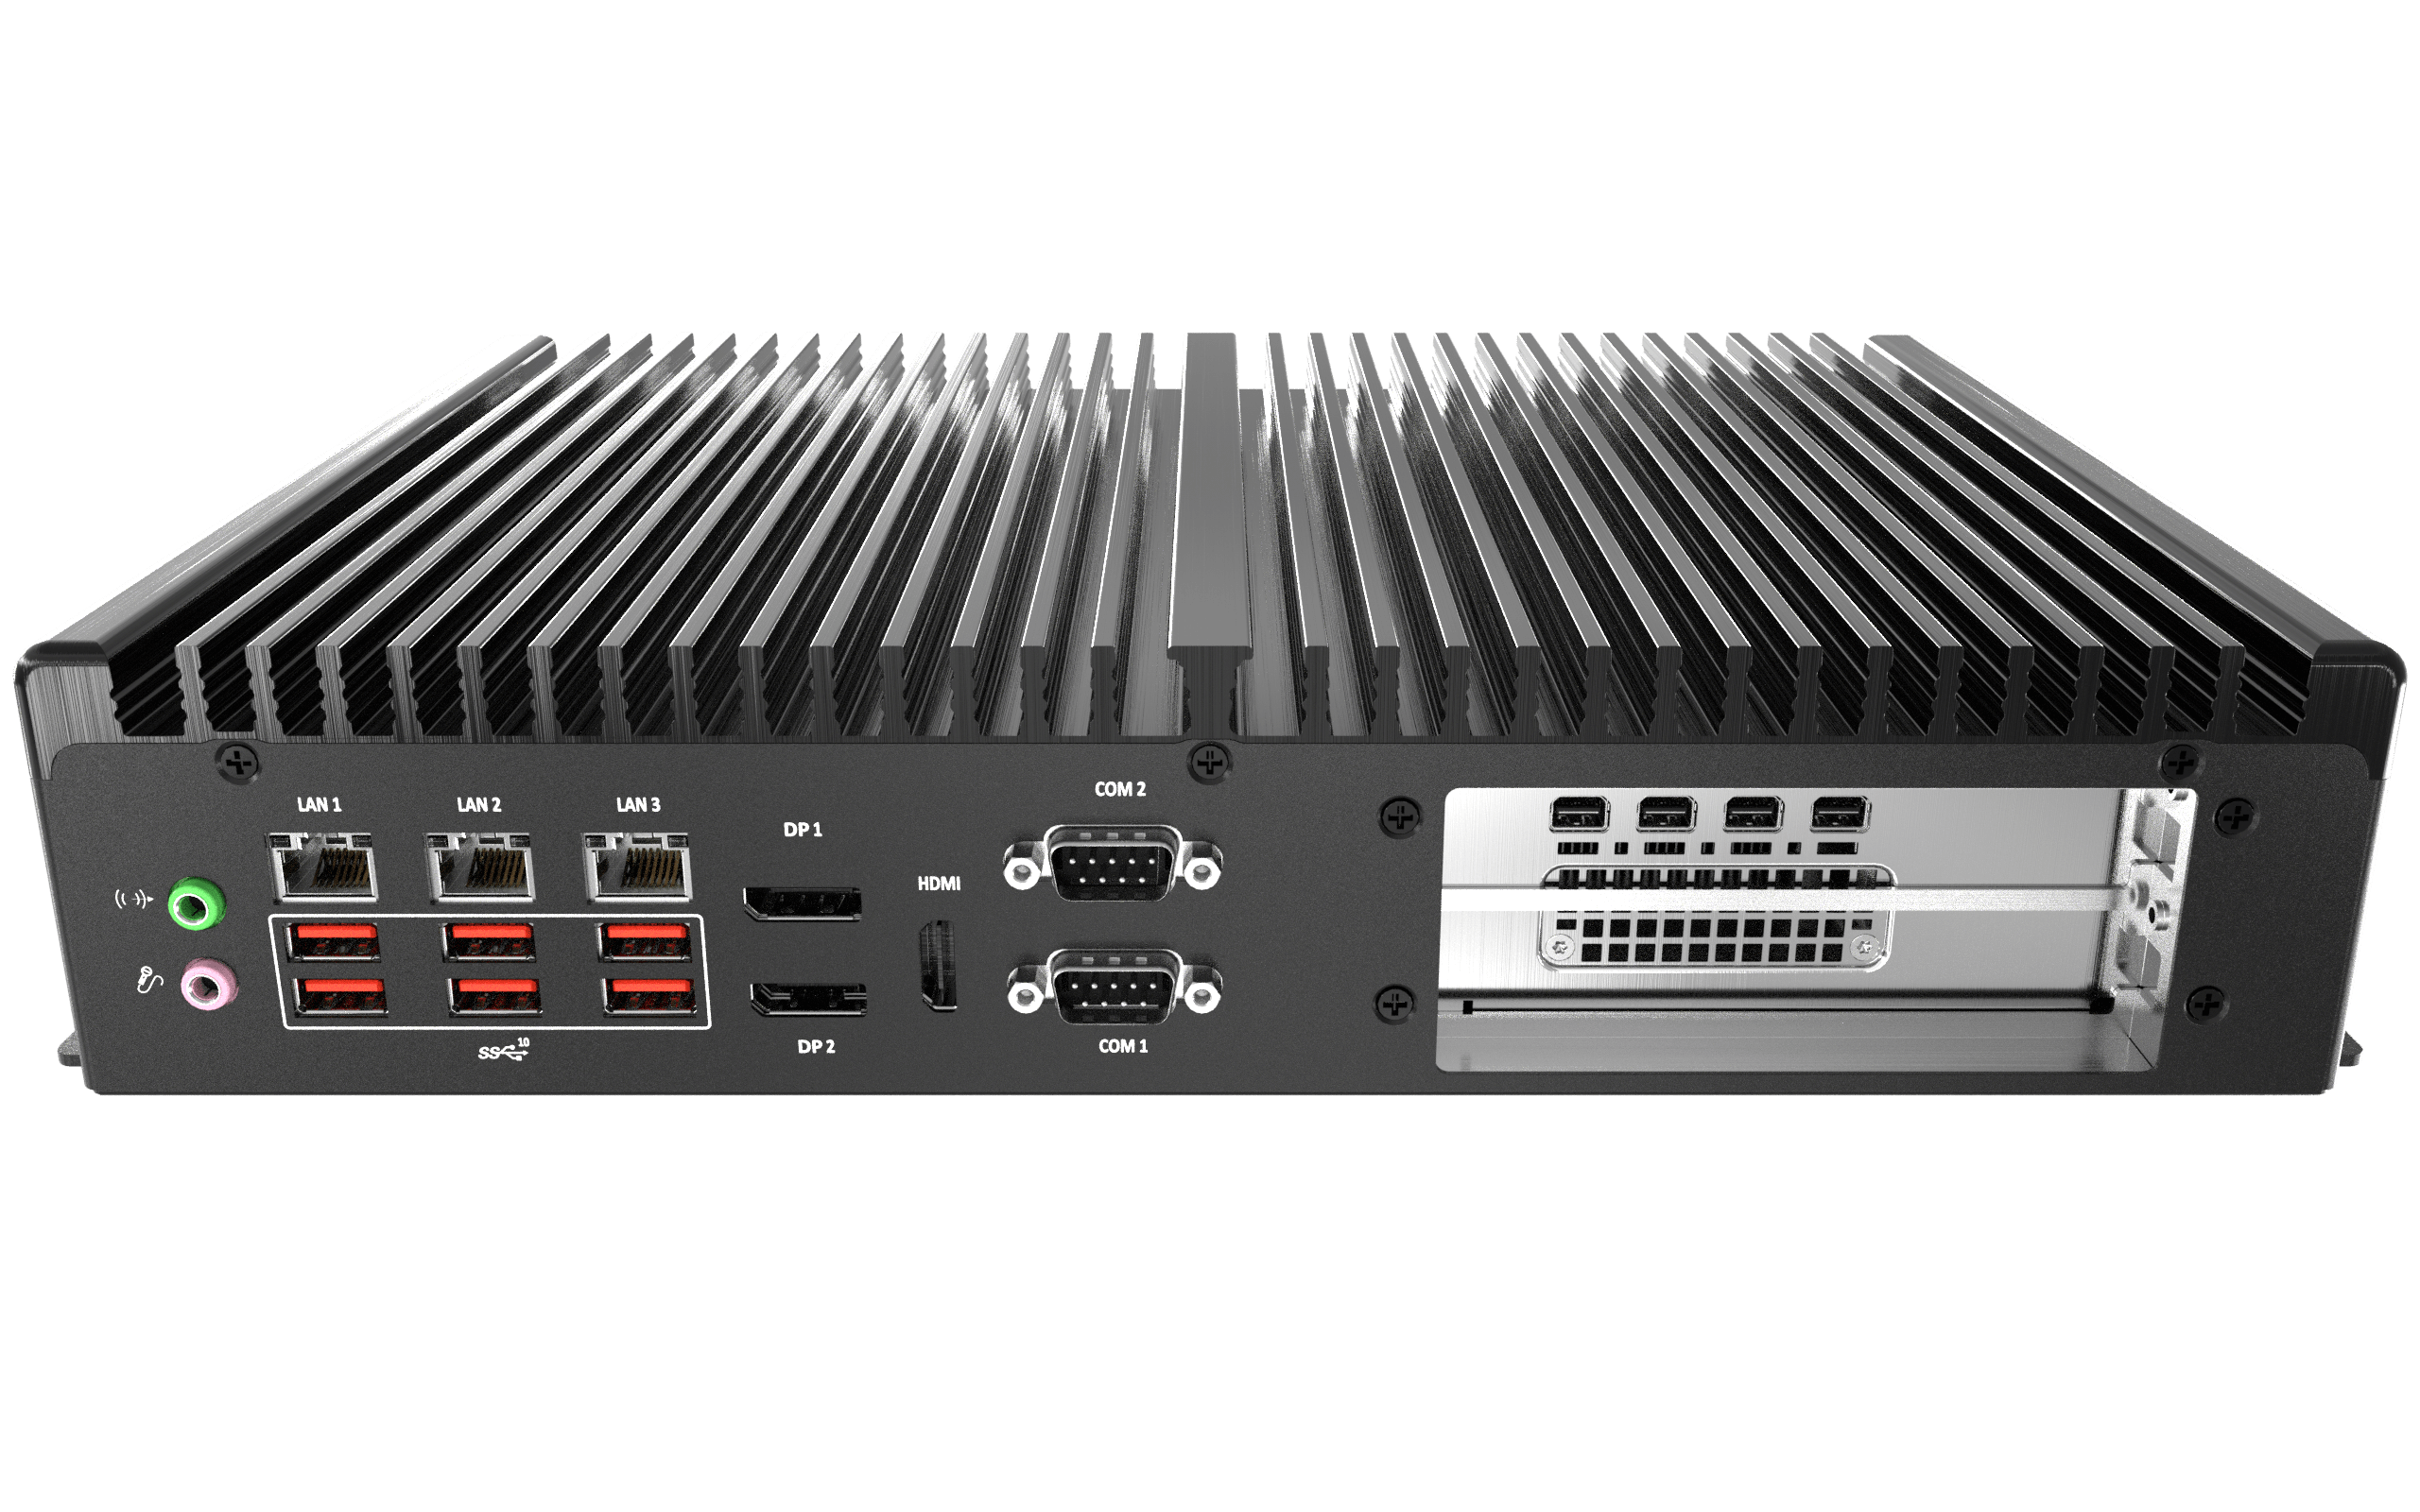
BCO-6000-RPL 高性能産業用コンピュータ |
インダストリアルエッジ | 第13世代インテル® Core™ TEプロセッサー(TDP 35W) | - LP、デュアルスロットGPU - PCIe Gen 4 |
アクティブ | 0℃~50℃ |

|
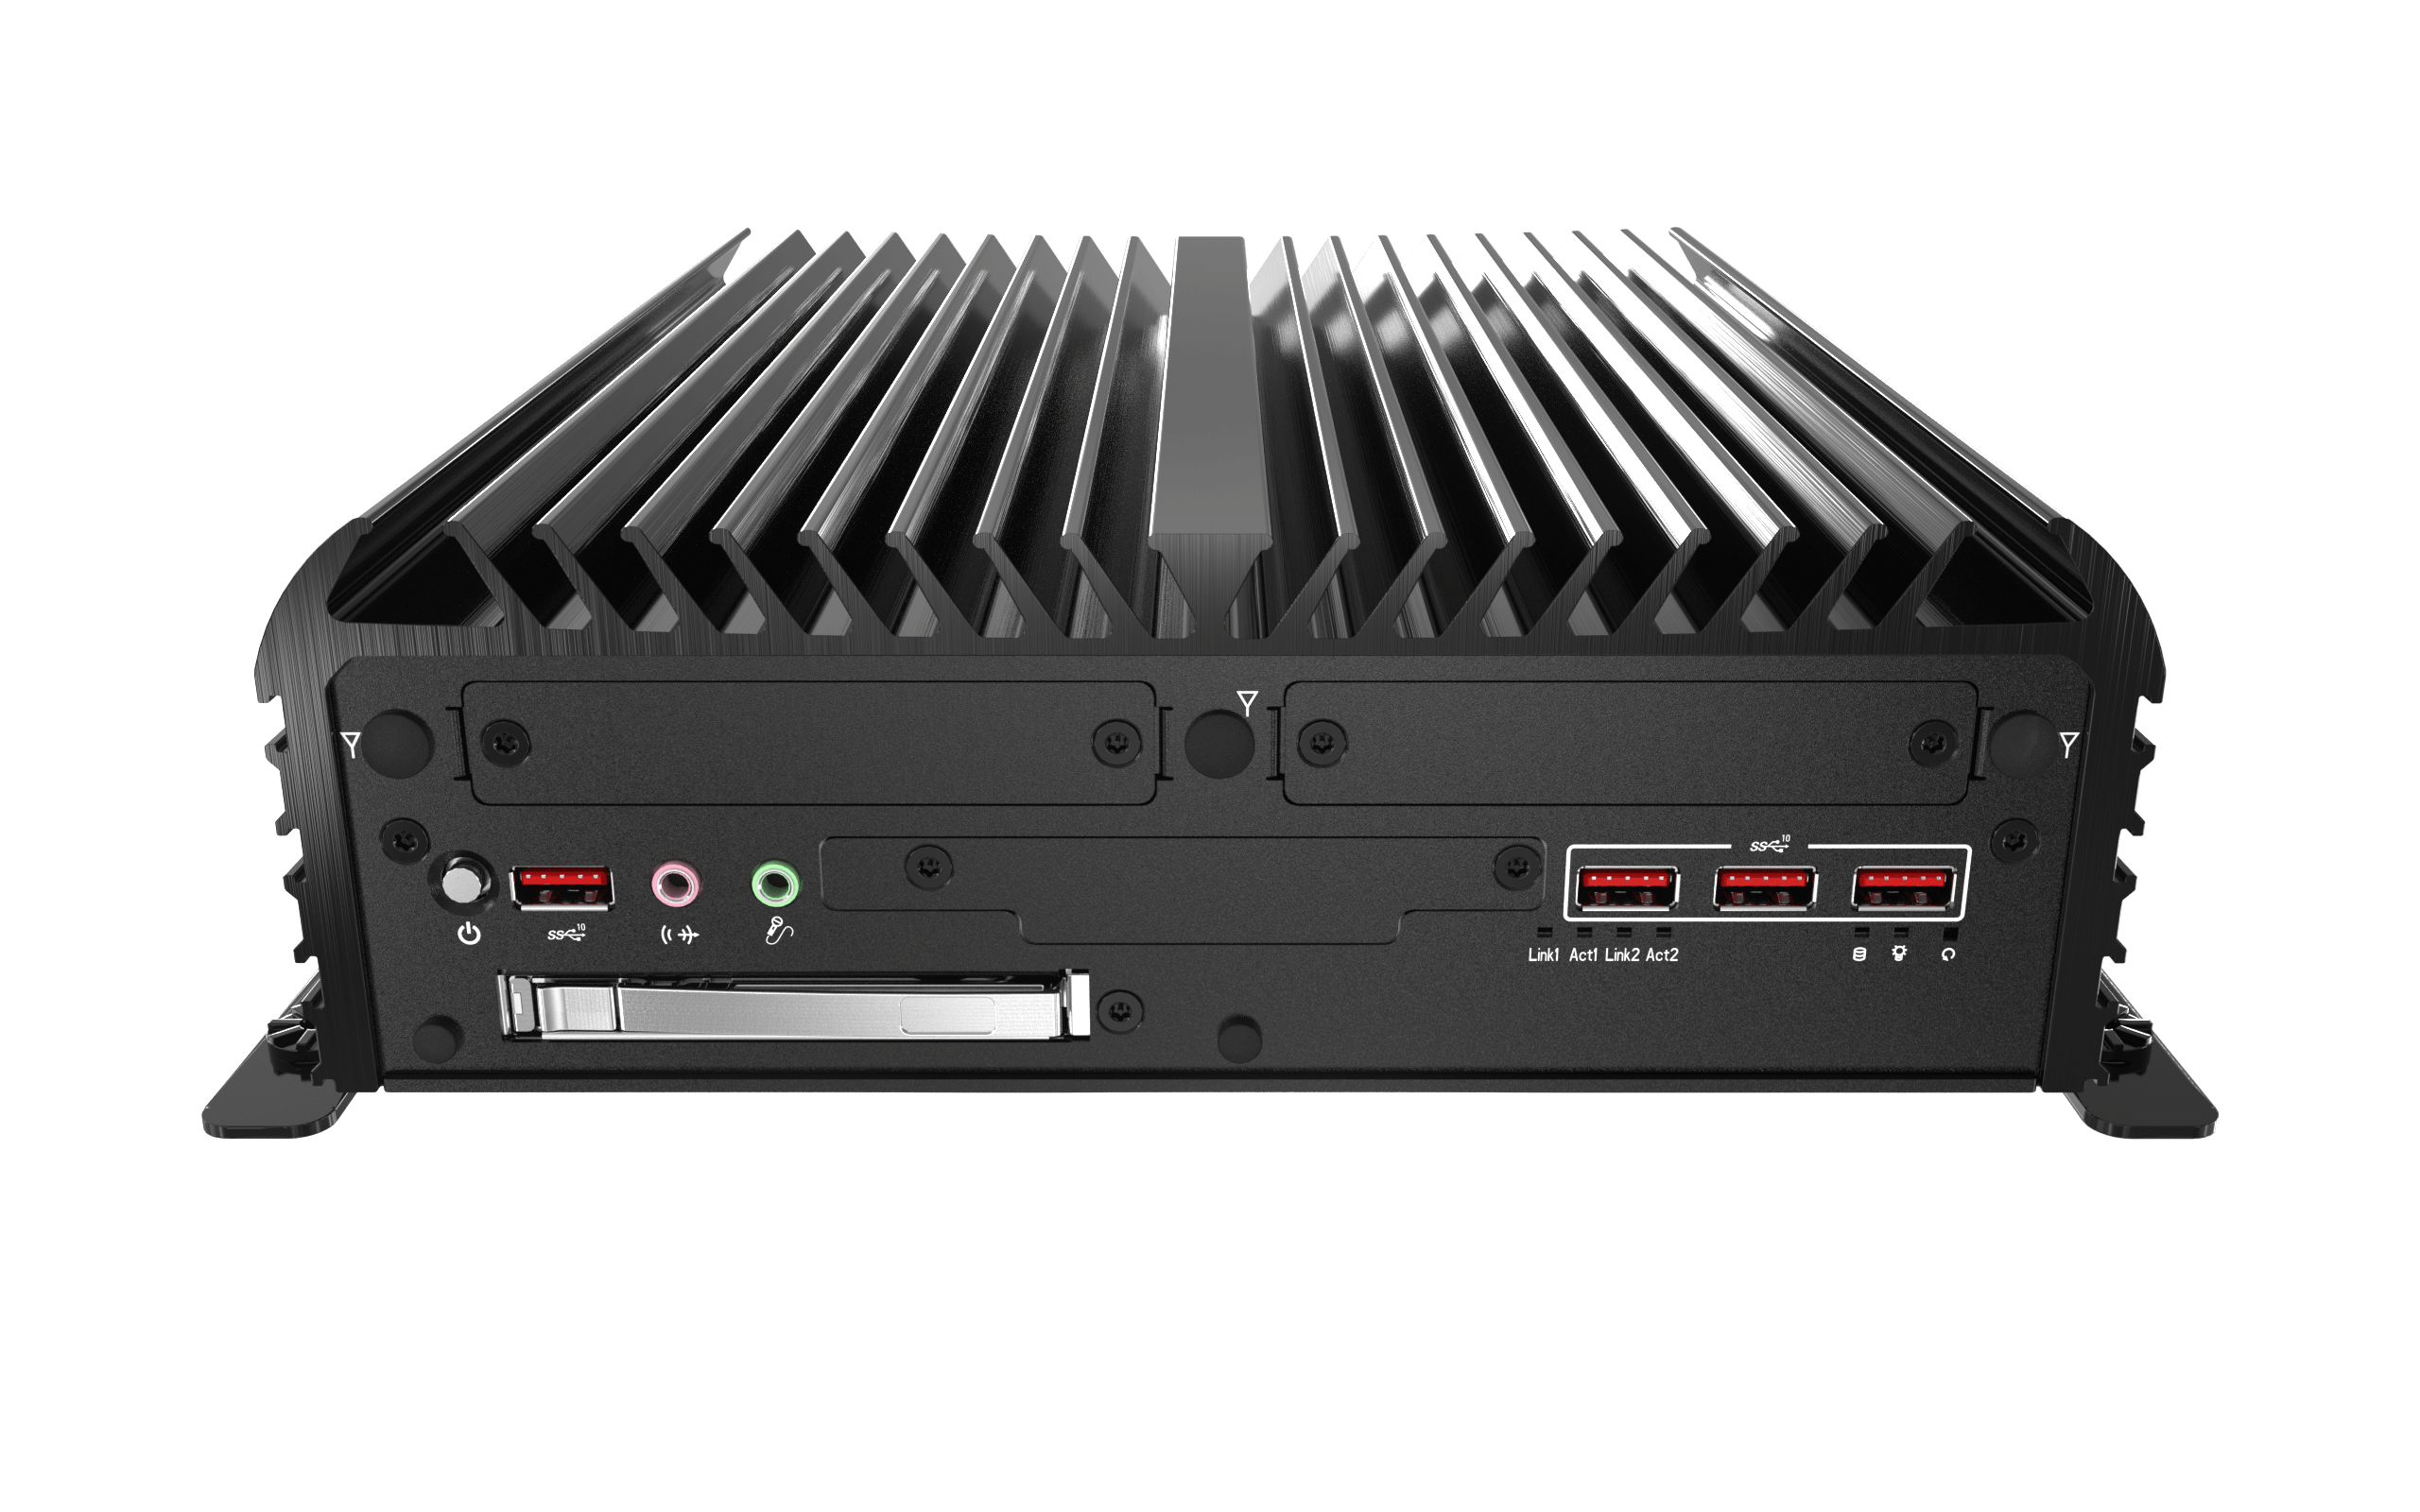
RCO-6000-RPL AIエッジ推論コンピュータ |
頑丈なエッジ | 第13世代インテル® Core™ TEプロセッサー(TDP 35W) | - LP、デュアルスロットGPU - PCIe Gen 4 |
アクティブ | -25℃~70℃ |

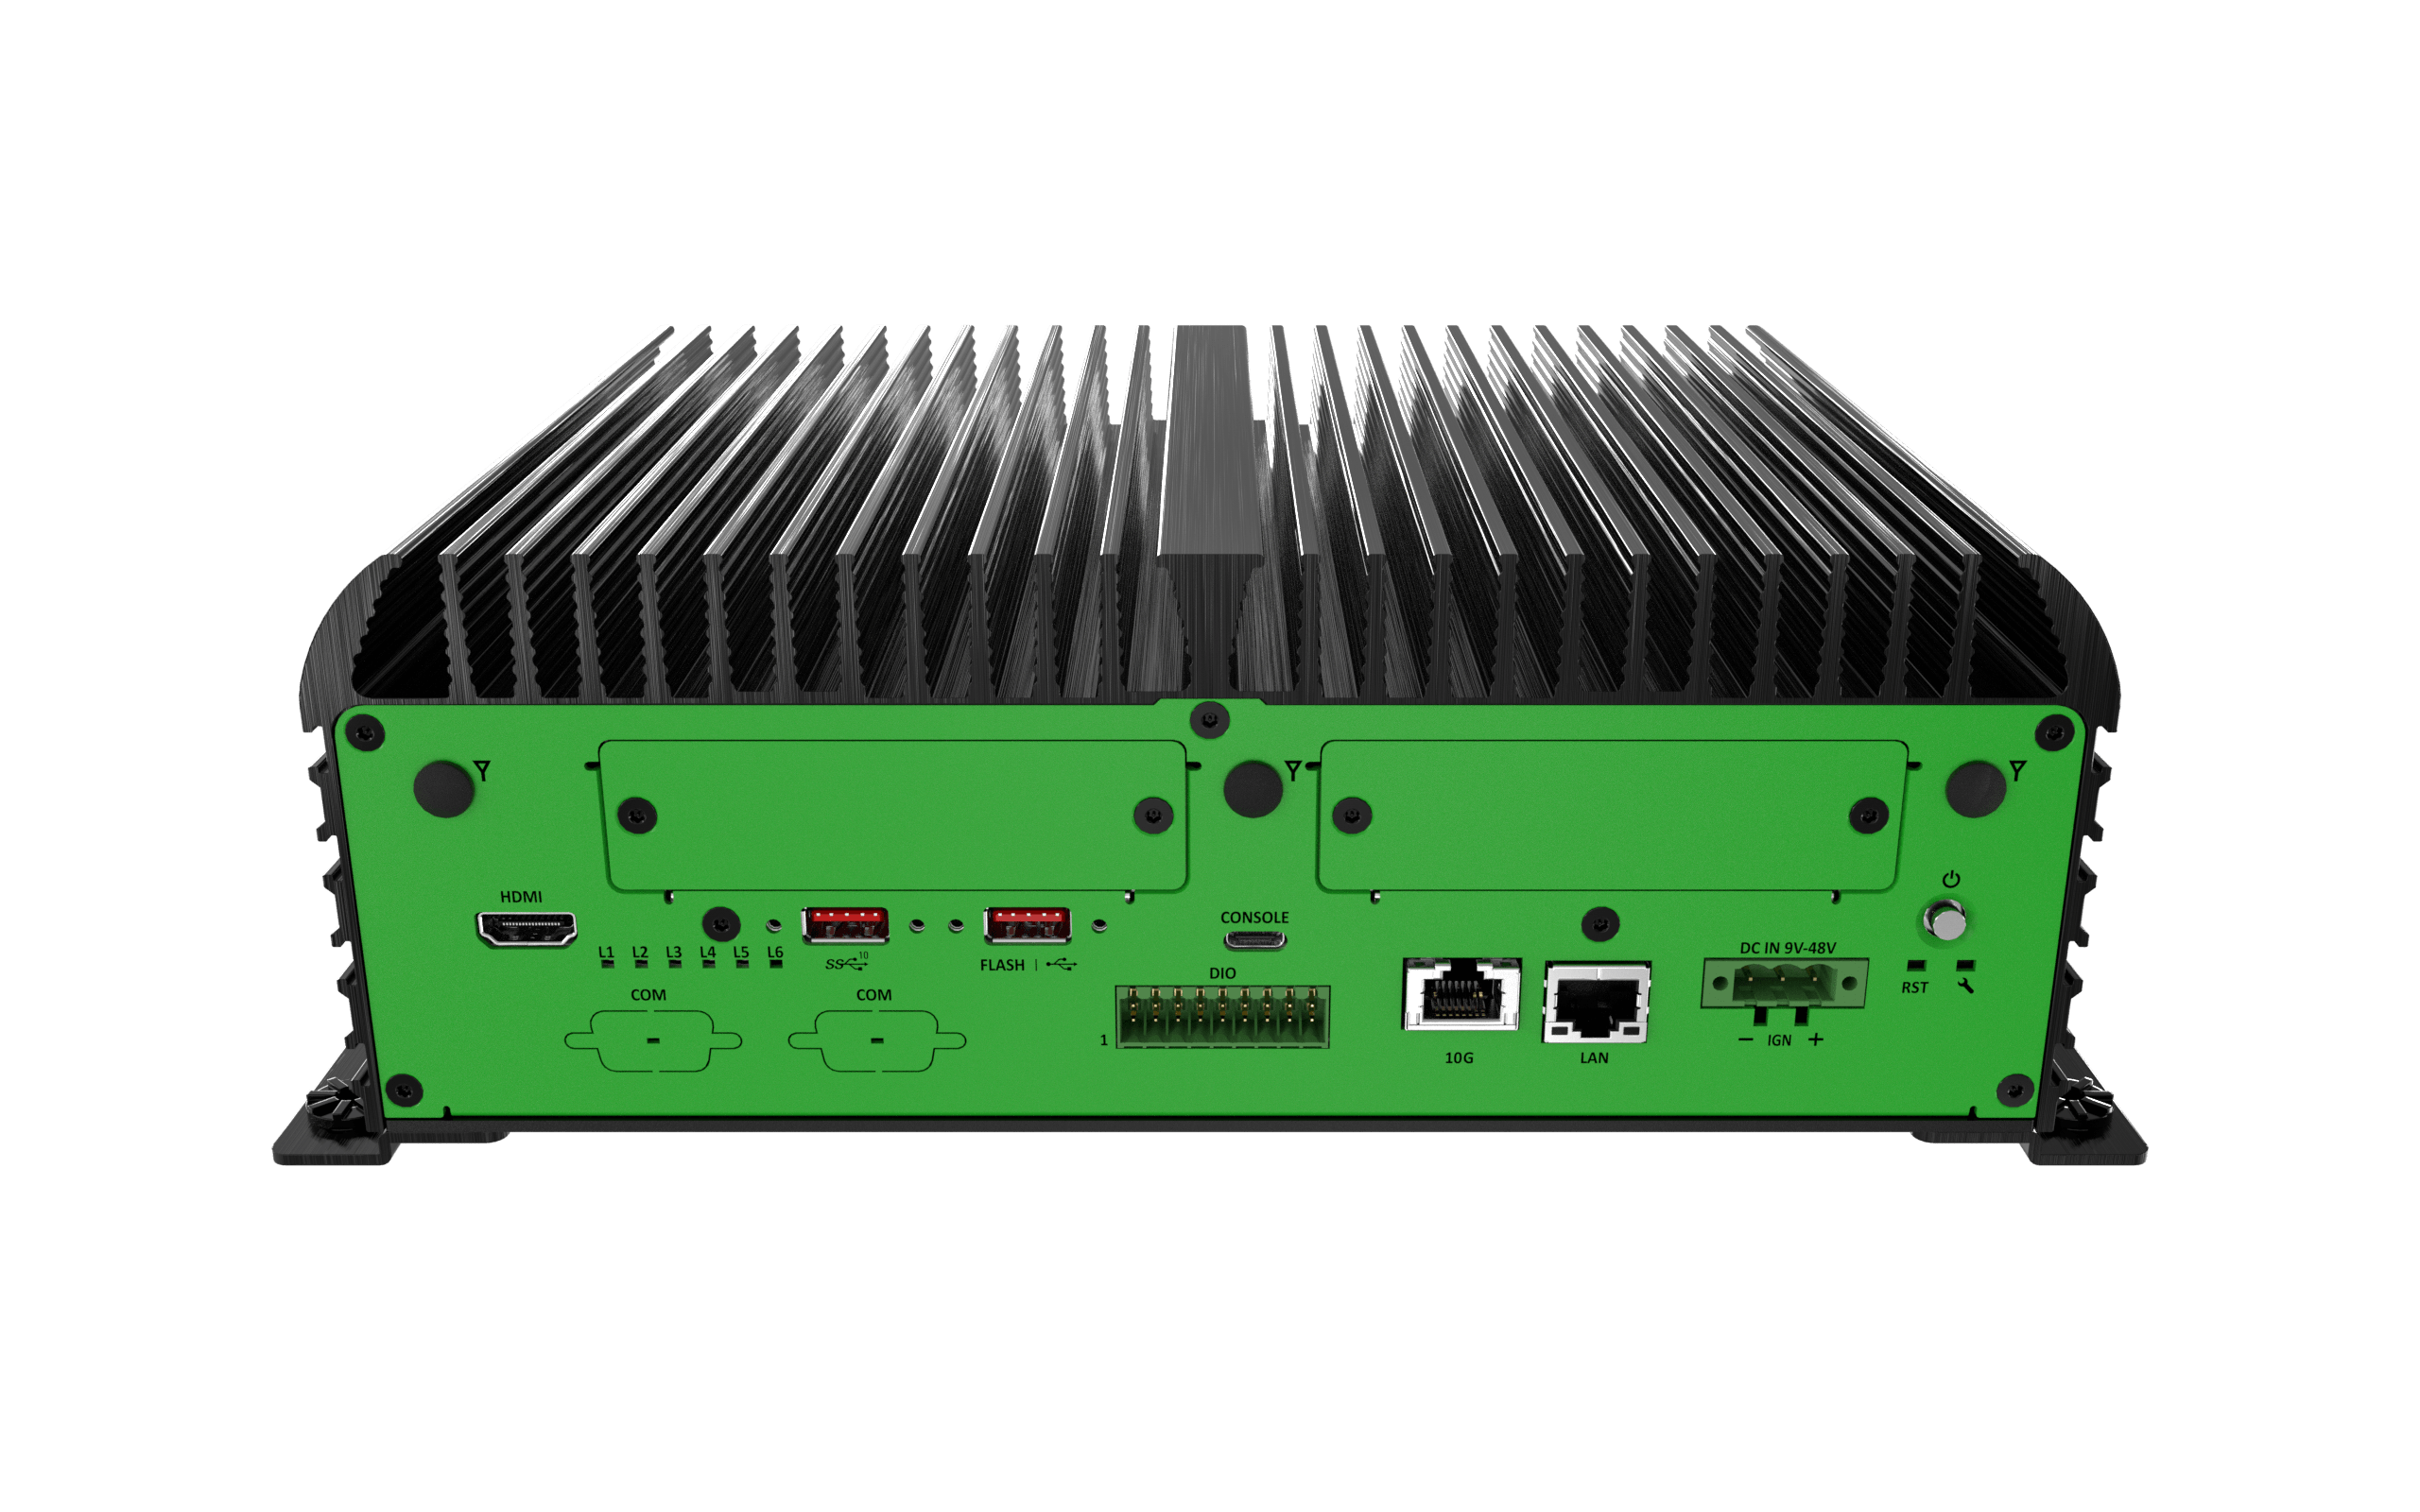
|
JCO-6000-ORN 高性能AIエッジコンピュータ |
頑丈なエッジ | NVIDIA® Jetson AGX Orin™ 32/64GB | - | 受け身 | -20℃~55℃ |

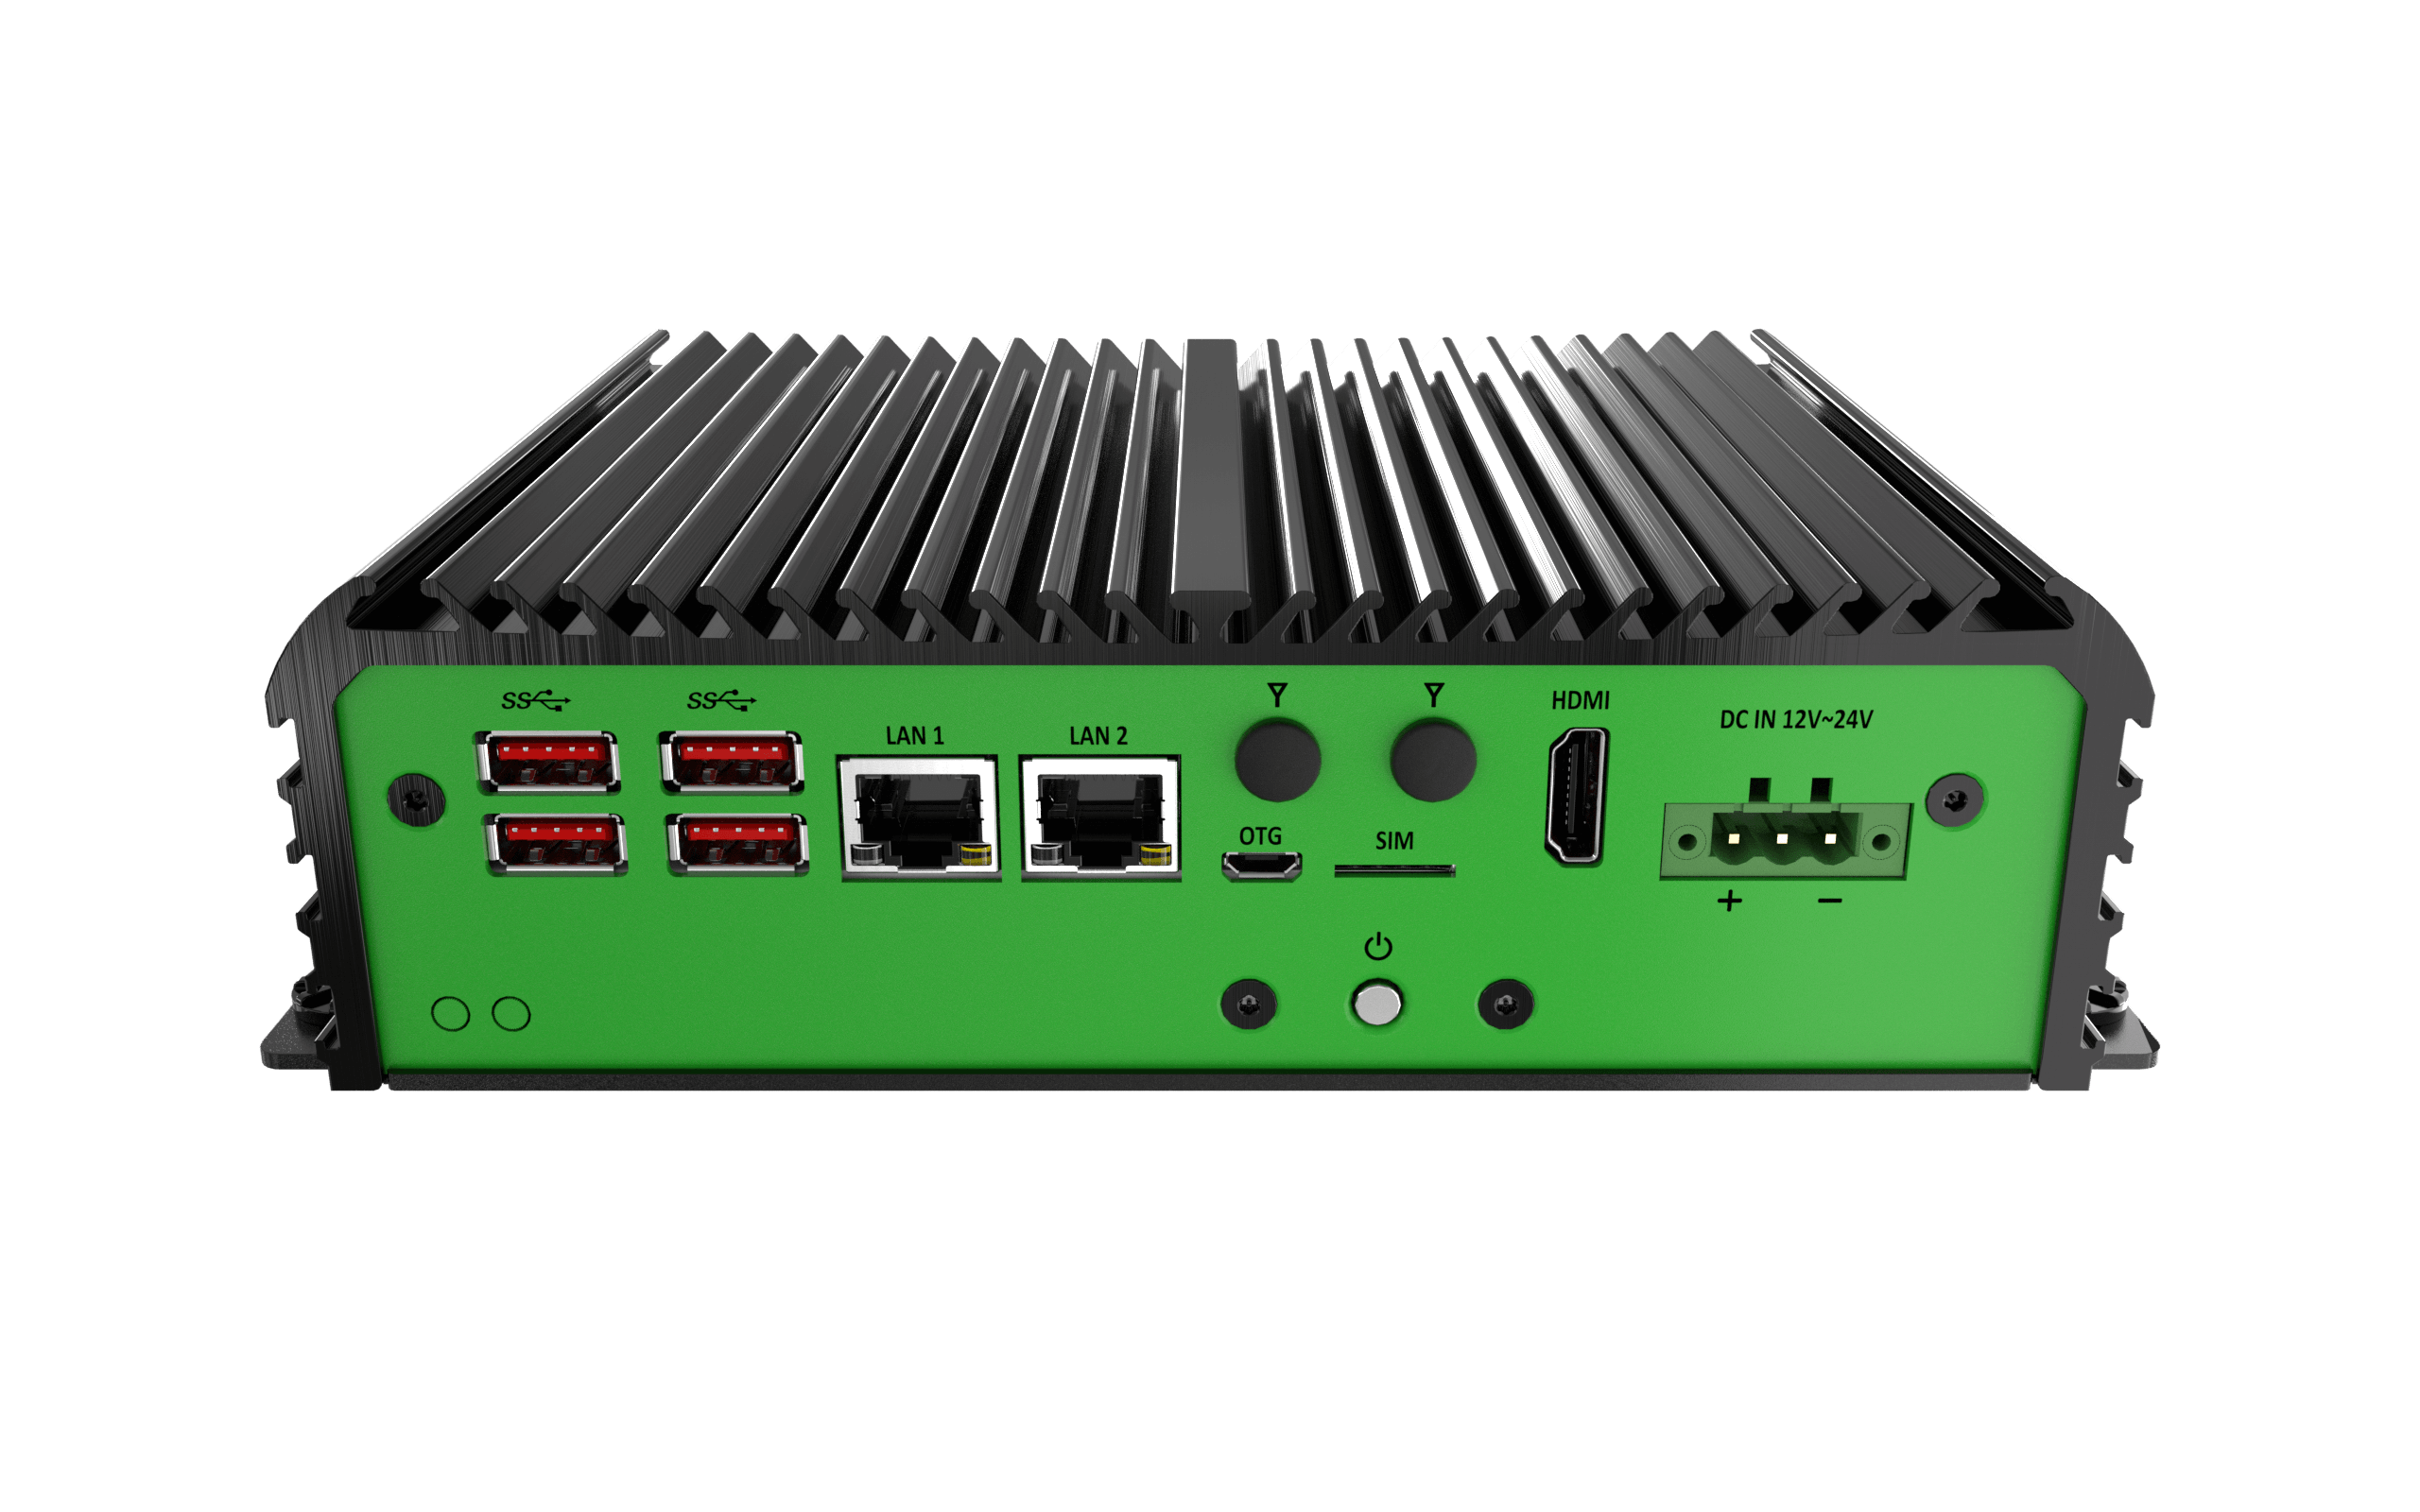
|
JCO-3000-ORN ミッドレンジAIエッジコンピュータ |
頑丈なエッジ | NVIDIA® Jetson Orin™ NX 8GB/16GB または Nano 4GB/8GB | - | 受け身 | -20℃~60℃ |

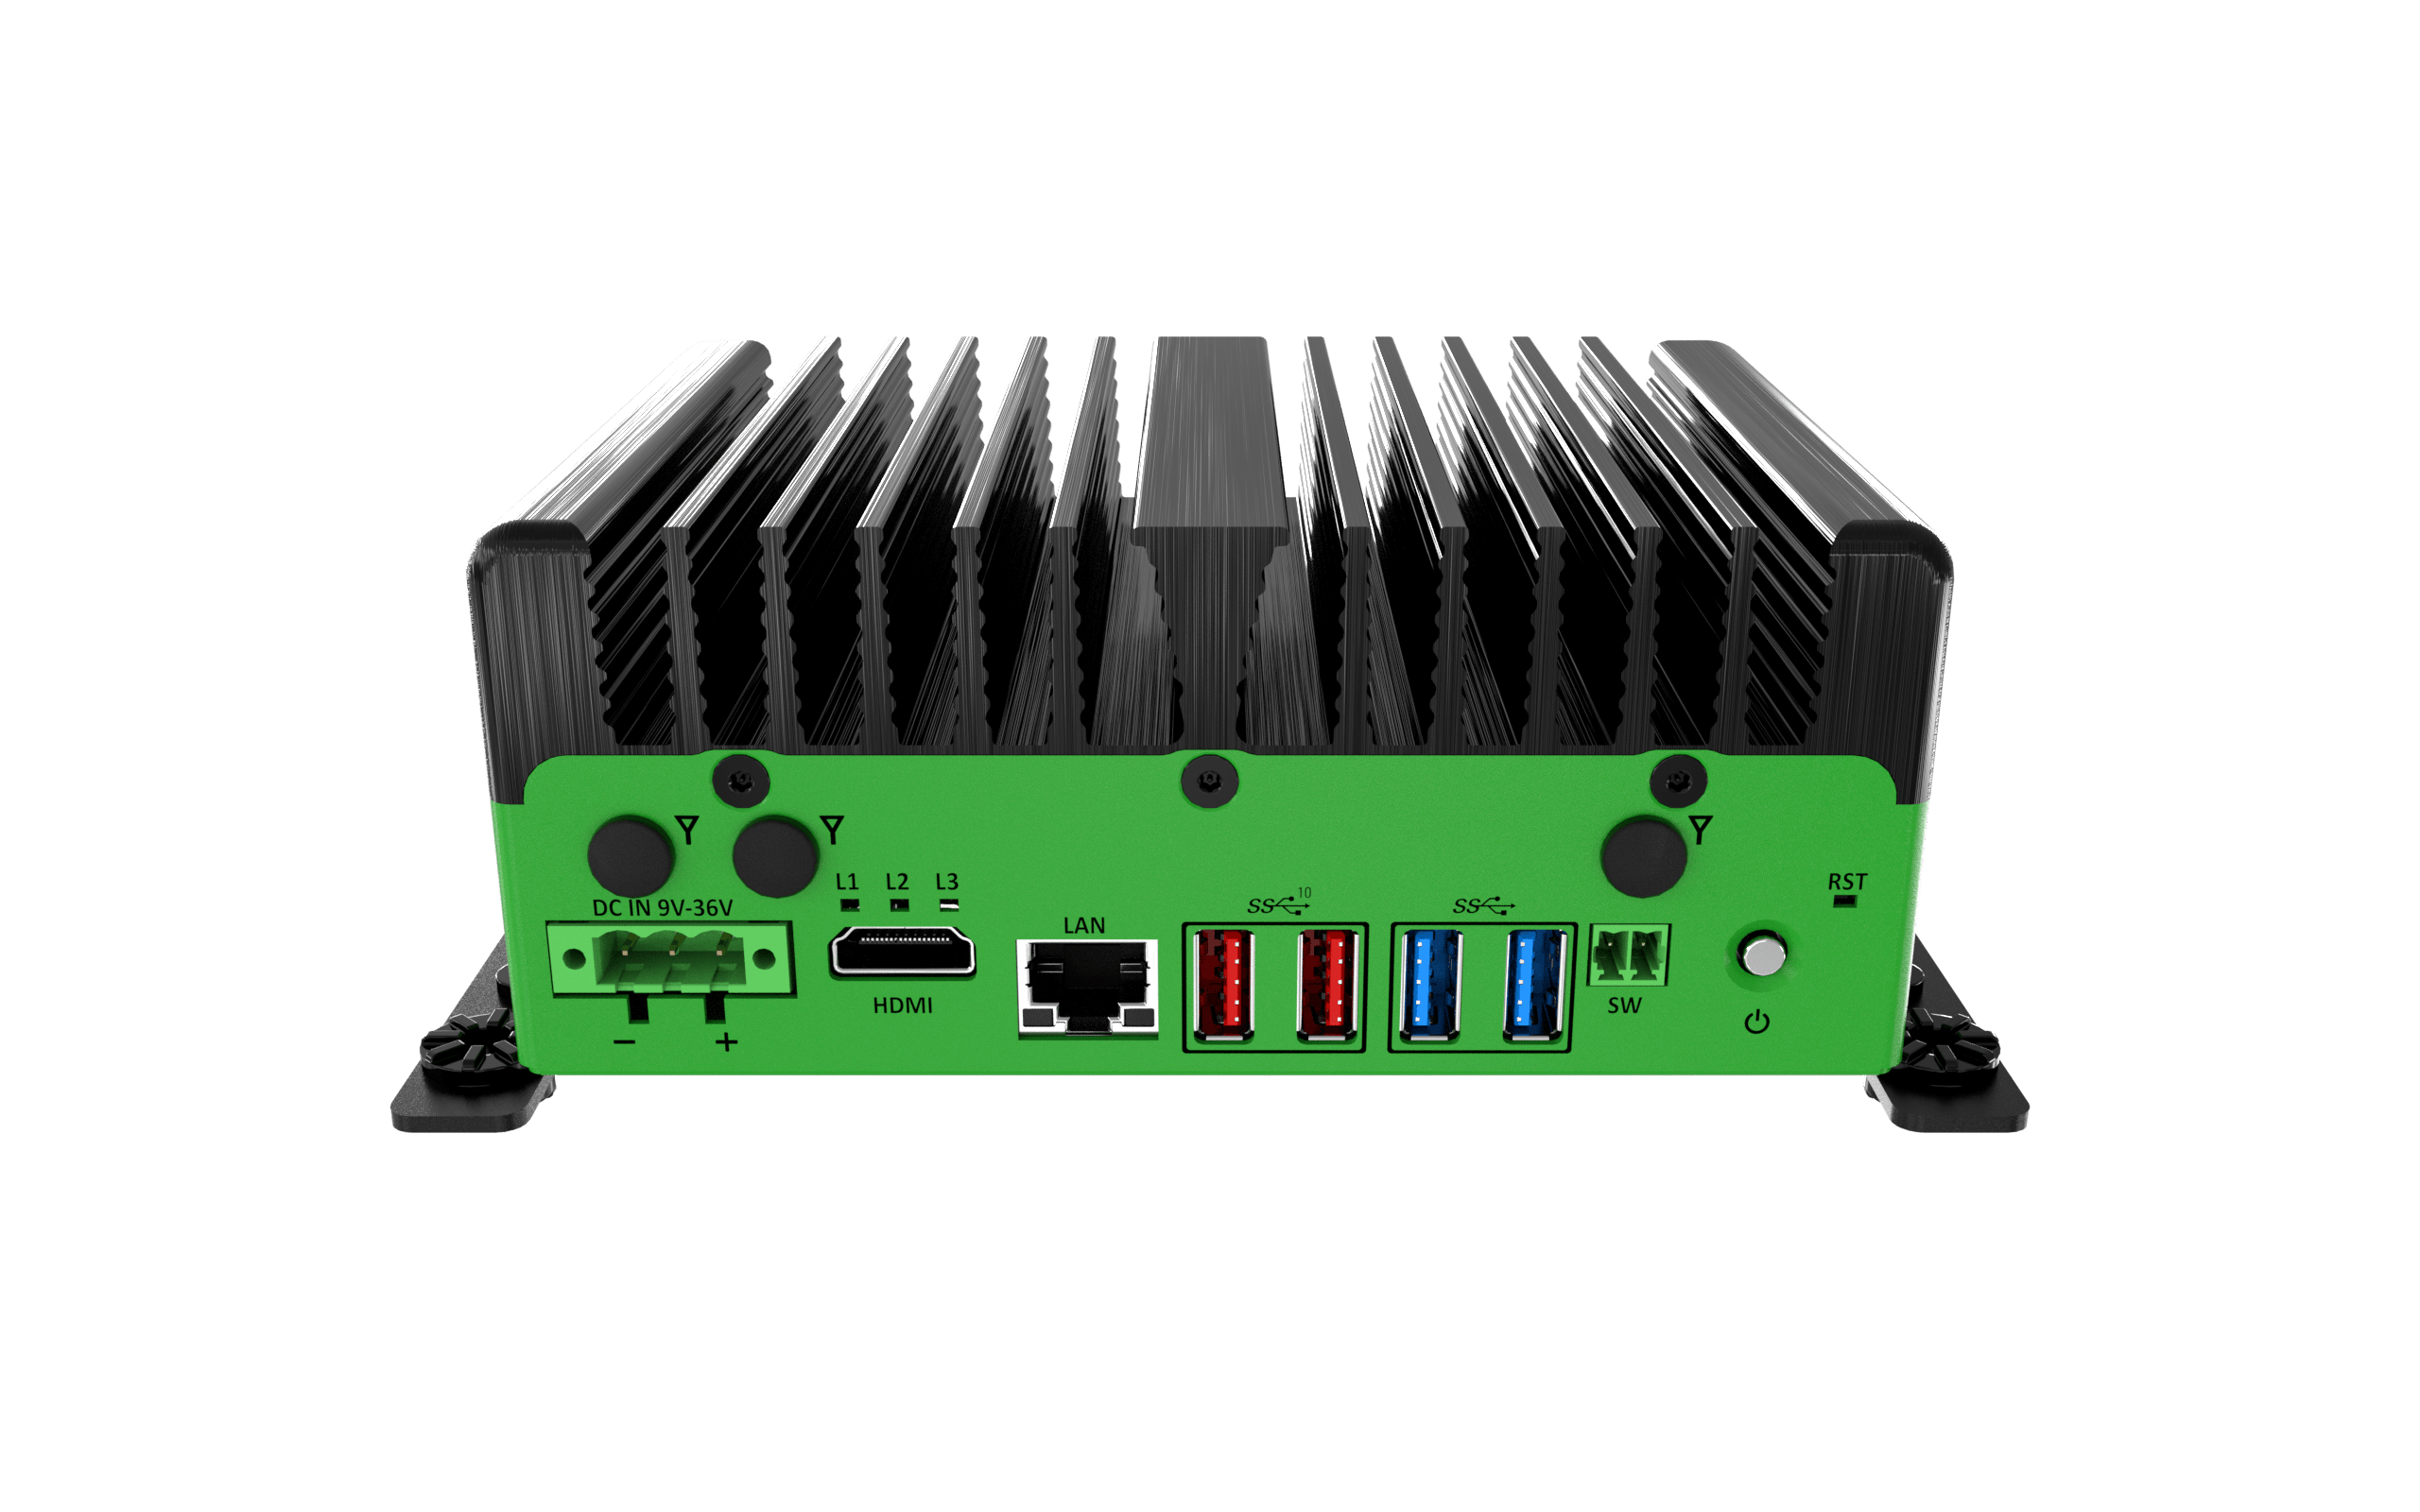
|
JCO-1000-ORN エントリーレベルのAIエッジコンピュータ |
頑丈なエッジ | NVIDIA® Jetson Orin™ NX 8GB/16GB または Nano 4GB/8GB | - | 受け身 | -20℃~55℃ |


|
WCO-6000-THR IP66 物理AIコンピュータ |
スペシャライズドエッジ | NVIDIA® Jetson AGX Thor™ (T4000/T5000) | - | パッシブ/アクティブ | -20℃~60℃ |


|
WCO-3000-ORN IP66 AIエッジコンピュータ |
スペシャライズドエッジ | NVIDIA® Jetson Orin™ NX 8GB/16GB または Nano 4GB/8GB | - | 受け身 | -20℃~60℃ |
NVIDIA GPUとJetsonモジュールの仕様
- サポート WCO Series
- サポート JCO Series
- サポート VCO-6000-RPL
- サポート LLM Series
- サポート KCO-3000-RPL
- サポート RCO-6000-RPL, KCO-2000-RPL
- サポート BCO-6000-RPL
組み込みコンピュータおよび産業用タッチディスプレイソリューションに関するソリューションガイドをダウンロードしてください。


Premioは、機械学習と人工知能を支える最新技術に関する深い知識を提供するNVIDIAパートナーネットワークの一員です。当社の堅牢なエッジコンピューティングソリューションは、NVIDIAのコンピューティング、仮想化、およびビジュアライゼーション製品群に含まれるエンタープライズパフォーマンスアクセラレーションカード(GPU)をサポートすることが検証されています。
もっと詳しく知る
Premioは、NVIDIAのプロフェッショナル向けGPUへのアクセスを提供するPNYのプロパートナーネットワークの一員です。PNYは、OEM、コンシューマー、チャネルエレクトロニクス市場におけるグローバルなテクノロジーリーダーです。1985年に設立されたPNYは、コンシューマー、システムインテグレーター、OEM、B2B企業に優れたサービスを提供し、30周年を迎えました。
もっと詳しく知る
Intel® Partner Alliance(IPA)は、インテルコーポレーションが提供するプログラムで、パートナー企業に様々な特典とリソースを提供します。このプログラムは、インテル製品およびテクノロジーを活用する企業間の連携、サポート、そして成長を促進することを目的としています。
もっと詳しく知る


産業用GPUコンピュータがエッジAIワークロードを効率化する方法
産業用GPUコンピュータは、GPUの並列処理能力、CUDA、およびテンソルコアを活用することで、エッジAIや機械学習のワークロードを高速化できます。これらの機能により、複数のタスクを同時に、かつ異なる精度で実行することが可能になり、計算が動的に調整されることで、精度を維持しながらスループットを向上させることができます。
主要技術:
- 並列処理アーキテクチャ
- テンソルコア
- CUDA(Compute Unified Device Architecture)


産業用GPUコンピュータがオンプレミス型GenAIワークロードを実現する方法
産業用GPUコンピュータは、予測保全、目視検査、自律運転などのアプリケーションにリアルタイム性能を提供することで、インダストリー4.0における生成型AIを実現します。強力なオンデバイス処理能力を備えたこれらのシステムは、速度、回復力、精度が極めて重要な産業環境にAI推論を直接もたらします。
NVIDIA JetsonがエッジAIコンピューティングをどのように強化するか
NVIDIA Jetsonモジュールは、エッジデバイスに高速なAIコンピューティングをもたらすために設計された組み込みコンピューティングプラットフォームのファミリーです。これらのモジュールは、コンパクトでエネルギー効率が高く、AIおよび機械学習ワークロードの実行に特化して設計された強力なGPUを搭載しています。
主なメリット:
- コンパクトな形状
- 低消費電力
- AIおよびMLタスク向けの高い計算性能


RISCアーキテクチャとCISCアーキテクチャの比較
堅牢なエッジコンピューティングアプリケーションでは、ARMアーキテクチャとx86アーキテクチャのどちらを選択するかは、アプリケーションの具体的な要件によって異なります。これらのアーキテクチャの詳細な違いと、エッジコンピューティングの導入においてそれぞれがもたらす主な利点について学びましょう。
主要市場
事例研究
よくある質問(FAQ)
GPUとCPUの違いは、その演算アーキテクチャとタスクの特化にあります。CPUは逐次処理を担当し、少数のコアを使用してタスク管理や負荷の高いシングルスレッドアプリケーションを実行します。一方、GPUははるかに多くのコアを持ち、並列処理を活用して複数のタスクを同時に処理します。CPUはオペレーティングシステムの実行とアプリケーションの管理を担当し、GPUは機械学習ワークロードの処理やグラフィックスのレンダリングを担当します。
NVIDIAのプロフェッショナル向けGPUとコンシューマー向けGPUの主な違いは、ワークロードの最適化、メモリ構成、そして電力と性能のバランスです。Quadroなどのプロフェッショナル向けNVIDIA GPUは、比較的低いTDPでAIワークロードの処理に特化している一方、RTXなどのコンシューマー向けNVIDIA GPUは汎用処理に重点を置いており、TDPははるかに高くなっています。
産業用コンピュータ向けGPUに関する包括的なガイドで、エッジコンピューティングに特化したGPUについてさらに詳しく学びましょう。
産業用GPUコンピュータは、エッジAIと連携し、複雑なワークロードアプリケーションを有効化および処理するために必要なコンポーネントを提供します。
まず、これらのコンピュータは、過酷な環境下でも耐えられるよう特別に設計されています。工場や屋外環境は、一般的に家庭用デスクトップコンピュータには適していません。なぜなら、いずれ故障してしまうからです。Premioの産業用GPUコンピュータはUL認証を取得しており、安全基準への準拠を保証するための徹底的なテストと検証を受けています。また、一部のコンピュータは、衝撃と振動に関するMIL-STD-810H規格にも準拠しています。
第二に、産業用GPUコンピュータは、CPUやGPUといった特定のコンポーネントを組み合わせることで最適なパフォーマンスを引き出すために、異種混在コンピューティングのアプローチを採用しています。GPUは並列処理において効率的かつ効果的である一方、CPUは逐次処理に強みを持っています。
3つ目はIoT接続性です。カメラやセンサーなど、多数のIoTデバイスが存在し、これらはすべて中央のコンピュータに接続して受信データを処理する必要があります。産業用GPUコンピュータは、IoTデバイスへの接続や電源供給に必要な互換性のあるI/Oを提供します。
堅牢な信頼性、処理能力、IoT接続性のバランスを取ることで、産業用GPUコンピュータは、過酷な環境下における複雑なエッジAIワークロードの実行を支援します。
はい、産業用GPUコンピュータは、マシンビジョンシステムの一部であり、マシンビジョンアプリケーションに必要な処理能力と入出力接続を提供するために、産業機械に組み込まれています。
堅牢型GPUコンピュータは、極端な温度、衝撃、振動、粉塵・破片といった過酷な環境条件に耐えるように設計された高性能コンピューティングシステムです。AI推論、画像認識、リアルタイム分析などの並列処理タスク向けに、強力なGPUアクセラレーション機能を統合しています。堅牢型GPUコンピュータは、信頼性とエッジでのパフォーマンスが極めて重要な産業オートメーション、防衛、輸送などの分野で広く採用されています。
AIエッジコンピュータは、ネットワークのエッジで人工知能ワークロードを直接処理するため、データをクラウドに送信する必要がなくなります。このアプローチにより、レイテンシが大幅に削減され、データプライバシーが強化され、リアルタイムでの意思決定が可能になります。AIエッジコンピュータは、ロボット工学、スマート製造、産業環境における予知保全など、時間的制約の厳しいアプリケーションに最適です。
ファンレスGPUコンピュータは、静音動作、システム信頼性の向上、そして経年劣化による故障の可能性のある可動部品を排除することでメンテナンスの手間を軽減します。パッシブ冷却と工業グレードのコンポーネントを採用したこれらのシステムは、埃っぽい環境や振動の多い環境に最適です。ファンレスGPUコンピュータは、耐久性と熱効率が不可欠なエッジAI環境で広く使用されています。
産業用AIコンピュータは、製造工場、倉庫、または遠隔地の現場において人工知能タスクを実行するために専用に設計されています。堅牢な構造とGPUなどのAIアクセラレーション機能を組み合わせることで、欠陥検出、品質検査、マシンビジョンといったタスクを実行します。これらのシステムは、幅広い温度範囲、高い耐衝撃性、および産業用プロトコルとのシームレスな統合を可能にするI/Oの柔軟性を備えています。
GPUエッジコンピューティングデバイスは、高性能なGPUアクセラレーションをデータソースにより近い場所で実現し、リアルタイム分析やAI推論を可能にします。これらのデバイスは、自動運転車、産業オートメーション、監視システムなど、低遅延処理が求められる環境において不可欠です。GPUエッジコンピューティングデバイスは、データをローカルで処理することで、ネットワーク帯域幅の使用量を削減し、運用効率を向上させます。
マシンビジョンコンピュータは、産業オートメーションのタスクにおいて、カメラやセンサーからの視覚データを処理・分析するために設計されています。通常、GPUアクセラレーション、高速I/Oポート(PoE、USB 3.2、ギガビットLANなど)、リアルタイム処理機能を備えています。マシンビジョンコンピュータは、物体追跡、バーコードスキャン、品質検査、ロボット誘導システムなどのアプリケーションに不可欠です。
堅牢型AIコンピュータは、ミッションクリティカルな環境や過酷な物理的環境への導入を想定して設計されています。標準的なAIシステムとは異なり、堅牢型AIコンピュータは、産業グレードのコンポーネント、幅広い温度範囲への対応、耐衝撃性・耐振動性、そして埃や湿気から保護する密閉型筐体といった特長を備えています。防衛、鉱業、運輸、屋外監視などの業界におけるエッジAIワークロードに最適です。